使用说明书
1. 产品概述
本系统是面向刑事辩护律师的一体化 AI 工作台:将纸质卷宗扫描件(PDF)结构化,由本地化大模型完成证据拆分、摘要、矛盾分析与辩护策略生成,最终输出可编辑、可导出的辩护报告。全部计算在单台 NVIDIA DGX Spark 上完成,案卷数据不出机、不出所。
1.1 核心特性
1.2 产品形态
- 桌面版:Tauri 打包的 macOS/Windows 应用,开箱即用;
- Web 版:同一套前端经浏览器访问(所内局域网多人协作场景),界面与桌面版完全一致;
- 后端:FastAPI 服务,承载任务编排、文件服务与 LLM 调度;
- 账号体系:支持远程认证服务器登录,亦可离线免登录使用。
2. 演示案例与脱敏声明
138****0012 形式。截图不含任何真实案件信息。2.1 演示案案情设定(虚构)
起诉意见书指控:陈某峰伙同李某军(另案处理)搭建虚假理财平台「金穗财富」APP,以月息 8% 高额返利为诱饵,骗取被害人王某兰(86 万元)、赵某国(12 万元)等共计 1,286,400 元,涉嫌诈骗罪。
- 卷宗:6 卷 —— 诉讼文书卷、证据卷 01–05(讯问/询问笔录、银行流水、电子数据、扣押清单);
- 证据:8 份,全部完成 LLM 拆分、命名与摘要;
- 预埋辩护点:指控金额(128.64 万)与银行流水(110.64 万)存在 18 万元差额、尾号 5517 账户流水未调取、两次供述分赃金额不一致;
- 研究产物:一次已完成的法律研究会话(诈骗罪数额认定与从犯认定)。
3. 案件管理
3.1 首页 · 我的案件
启动后进入案件仪表盘。全部案件以卡片陈列,显示案件名称、被告人、创建时间、文件数与状态标签。
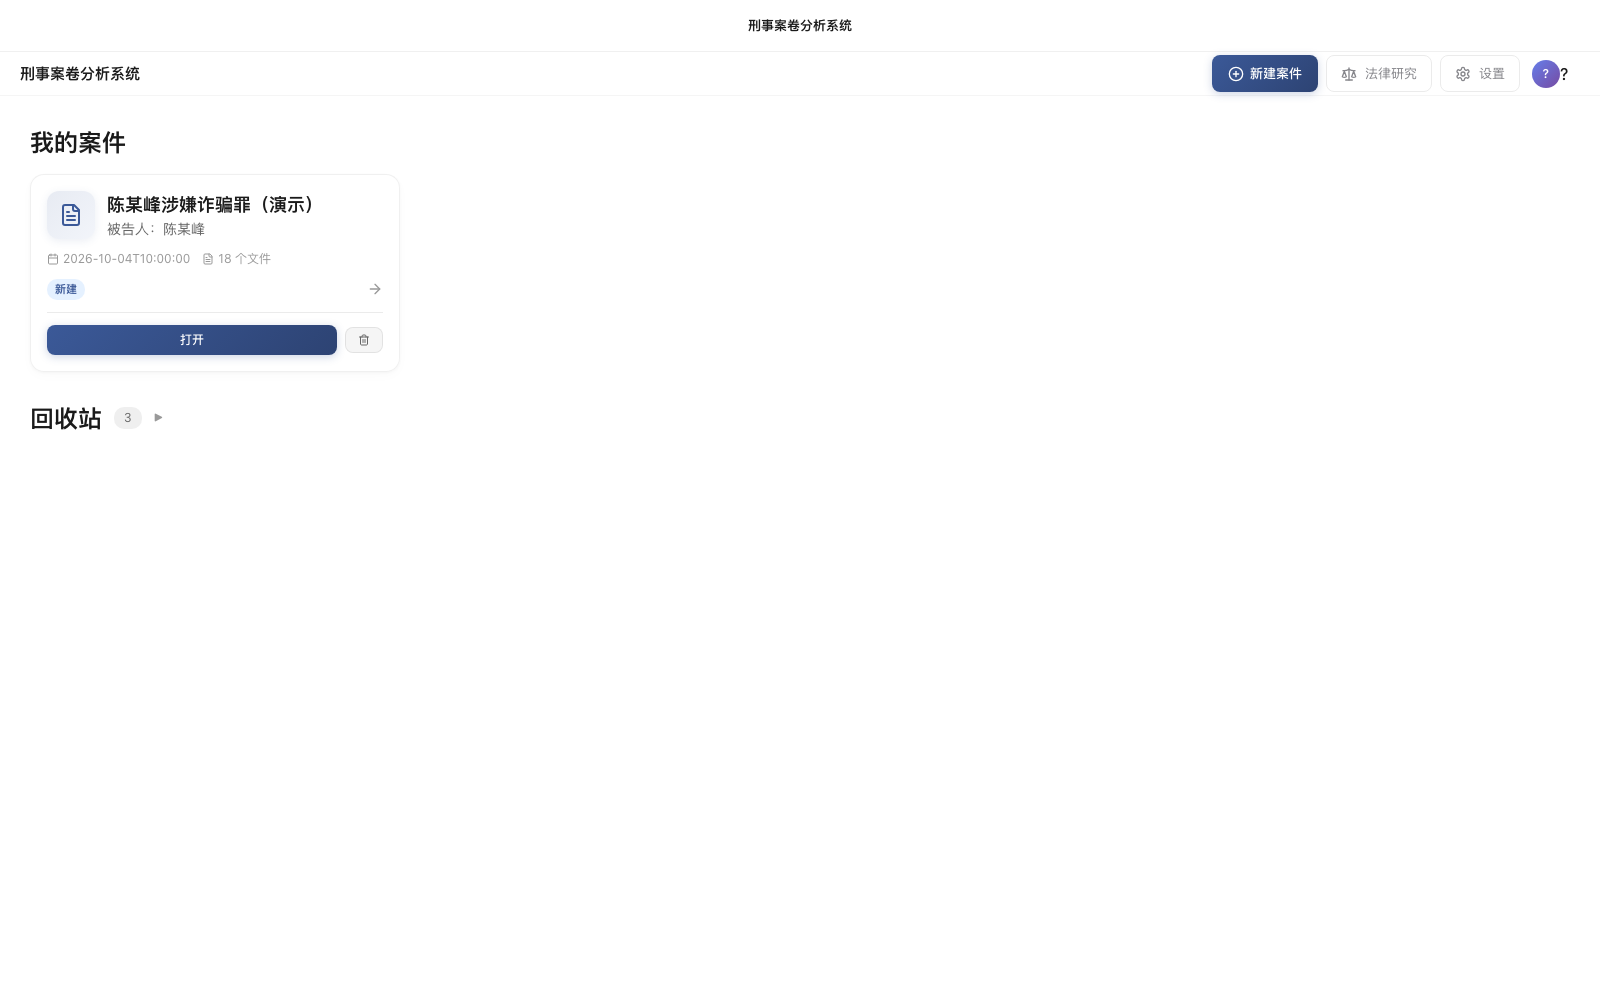
| 控件 | 类型 | 功能说明 |
|---|---|---|
| 新建案件 | 按钮(顶栏) | 打开新建案件向导,创建案件工作区 |
| 法律研究 | 按钮(顶栏) | 进入法律研究中心(见第 6 章) |
| 设置 | 按钮(顶栏) | 进入系统设置(见第 7 章) |
| 案件卡片 | 卡片 | 展示案件名称、被告人、创建时间、卷宗文件数、状态标签 |
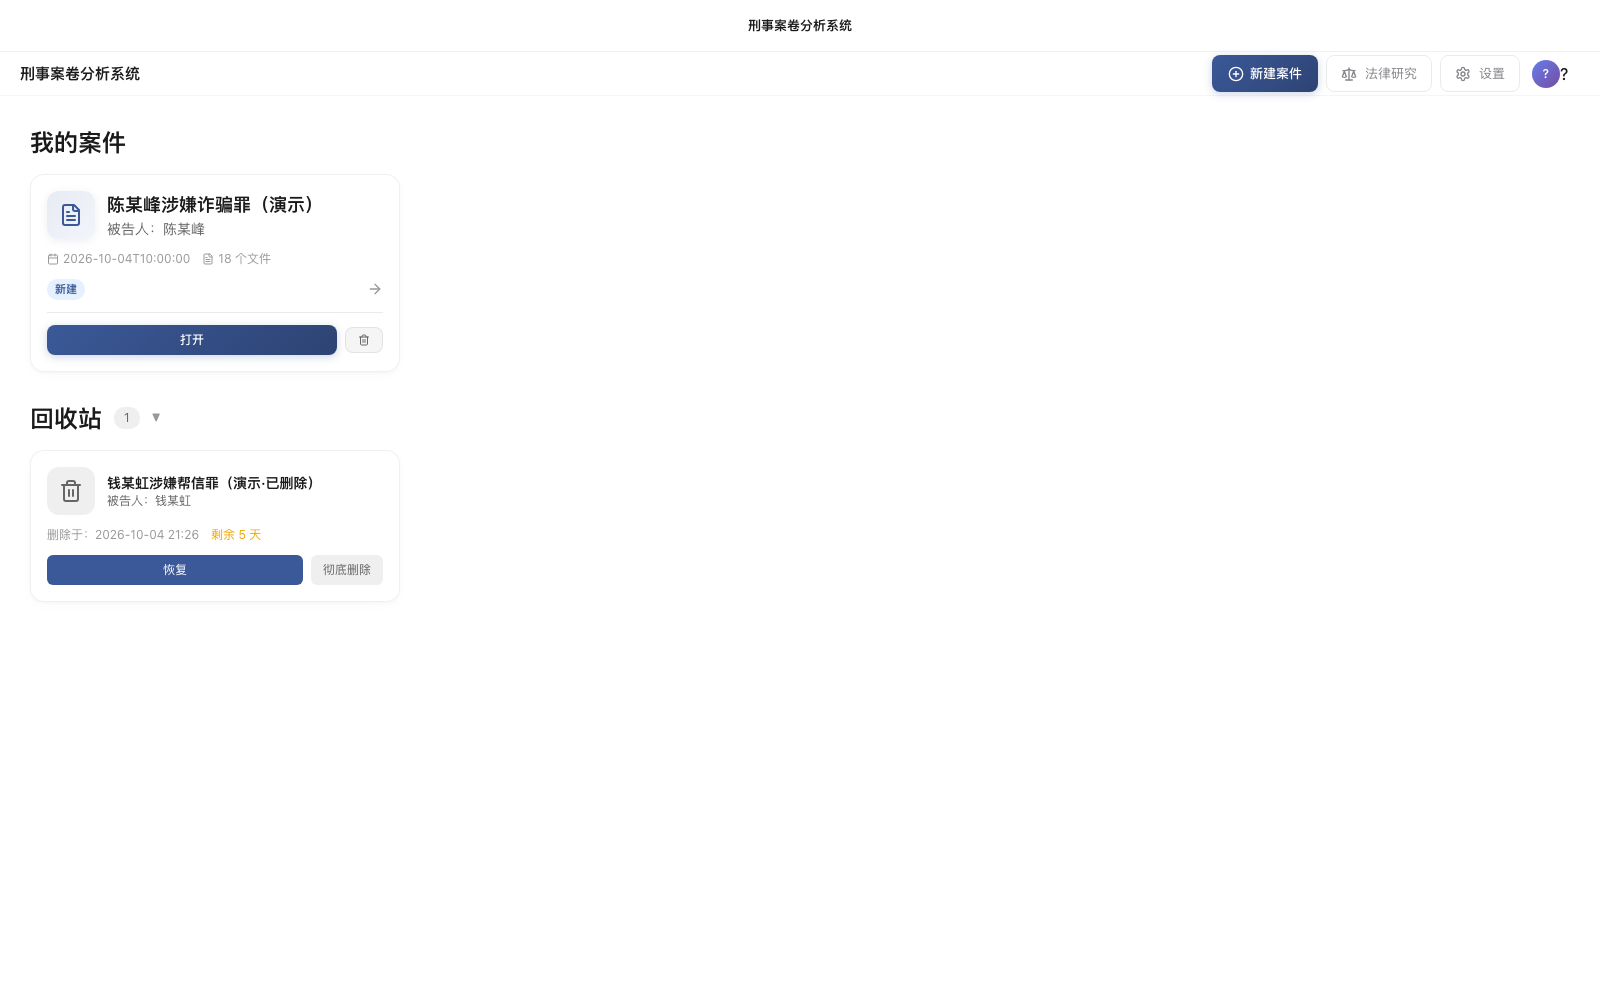
| 回收站 | 折叠区 | 删除的案件先进入回收站,保留若干天后自动清除,期间可随时恢复 |
3.2 回收站
删除的案件先进入回收站并保留若干天(界面显示「剩余 N 天」倒计时),到期自动清除;期间可随时恢复。「彻底删除」为物理删除,不可恢复,操作前有二次确认。
3.3 新建案件
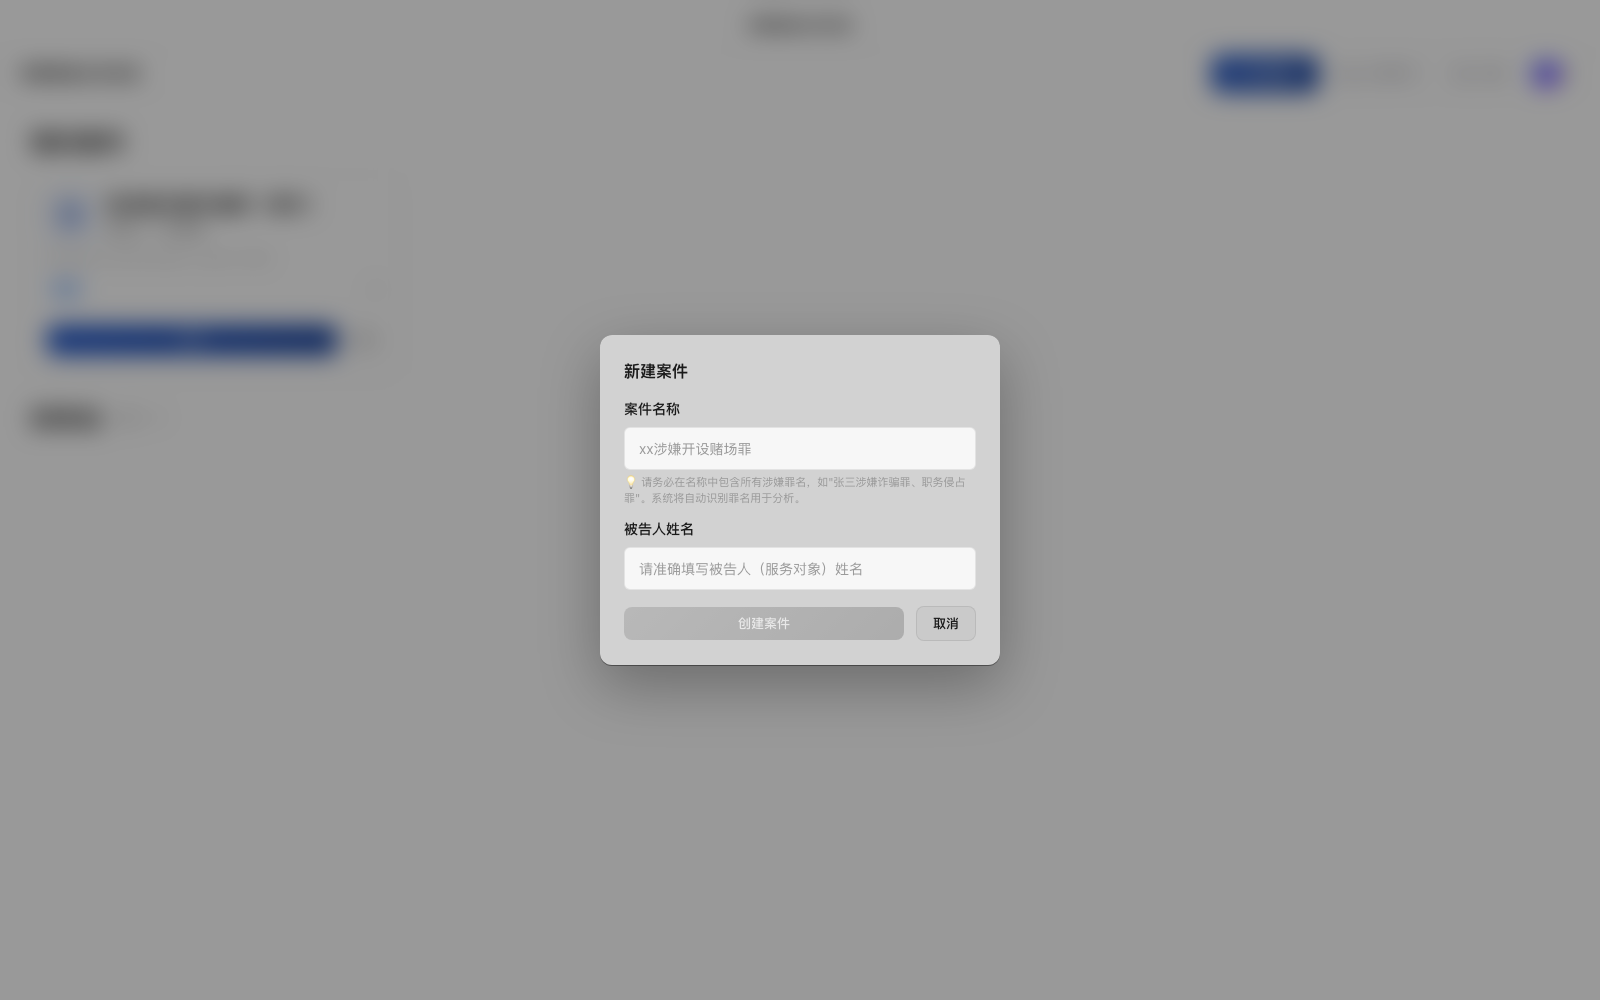
点击「新建案件」弹出向导。仅需案件名称(建议格式「xx 涉嫌某罪」)与被告人姓名两项即可建案;系统按命名自动生成 original/ processed/ md/ evidence/ summaries/ analysis/ research/ 标准目录结构。
4. 案件工作台(三步法)
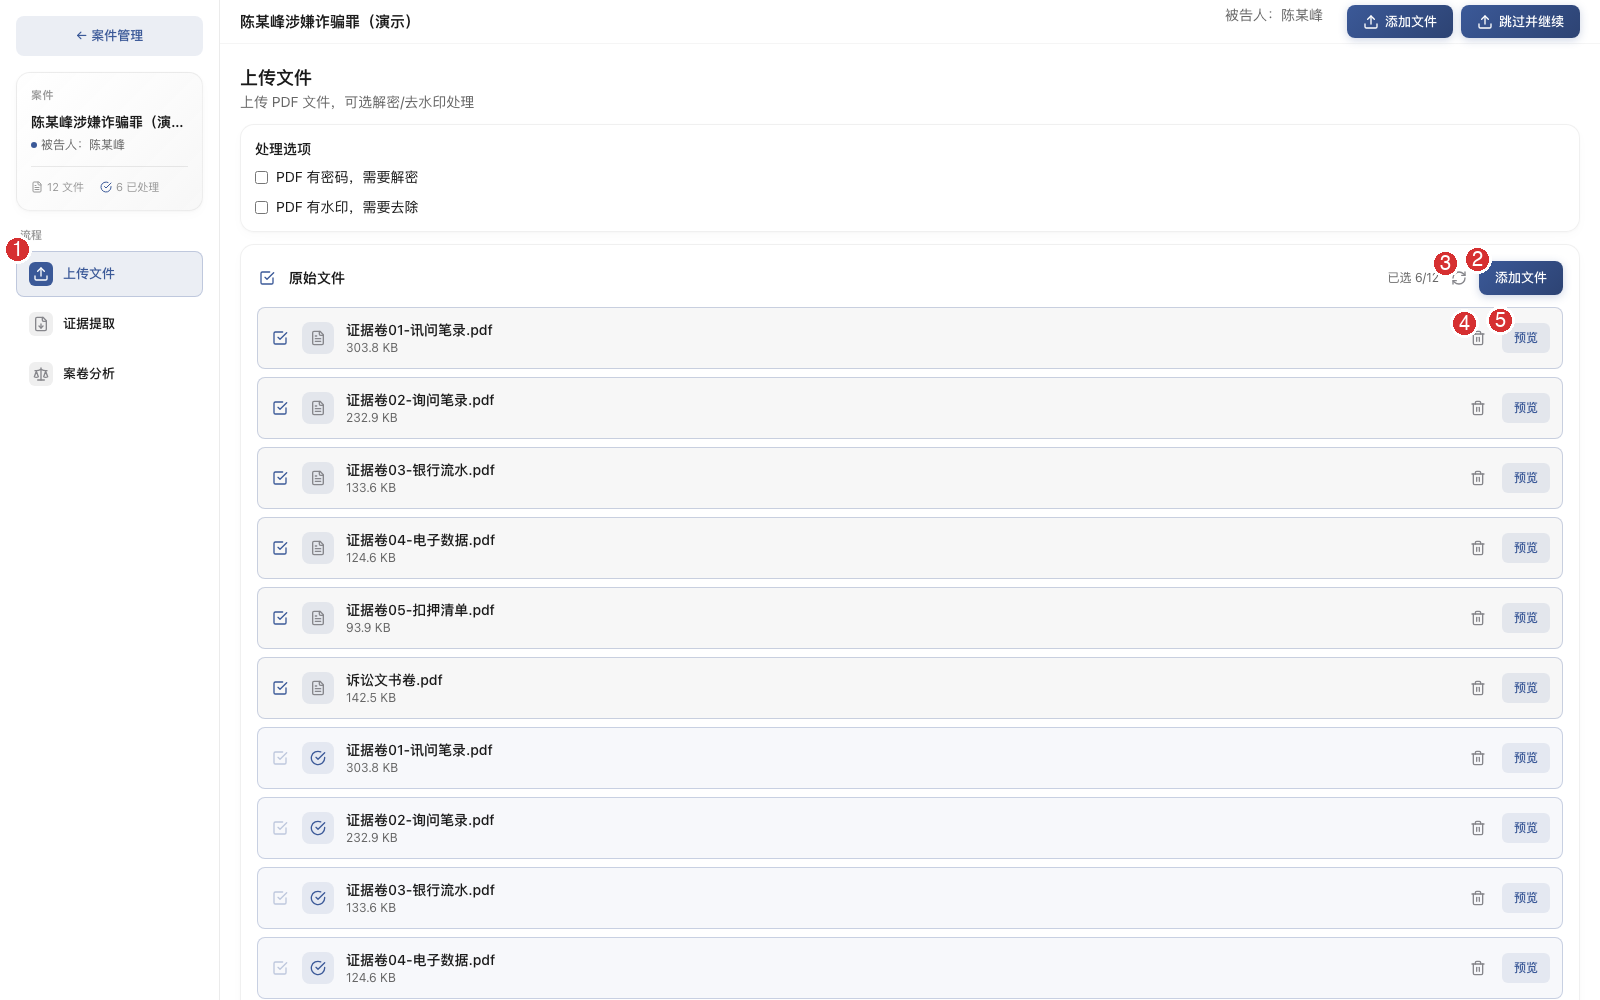
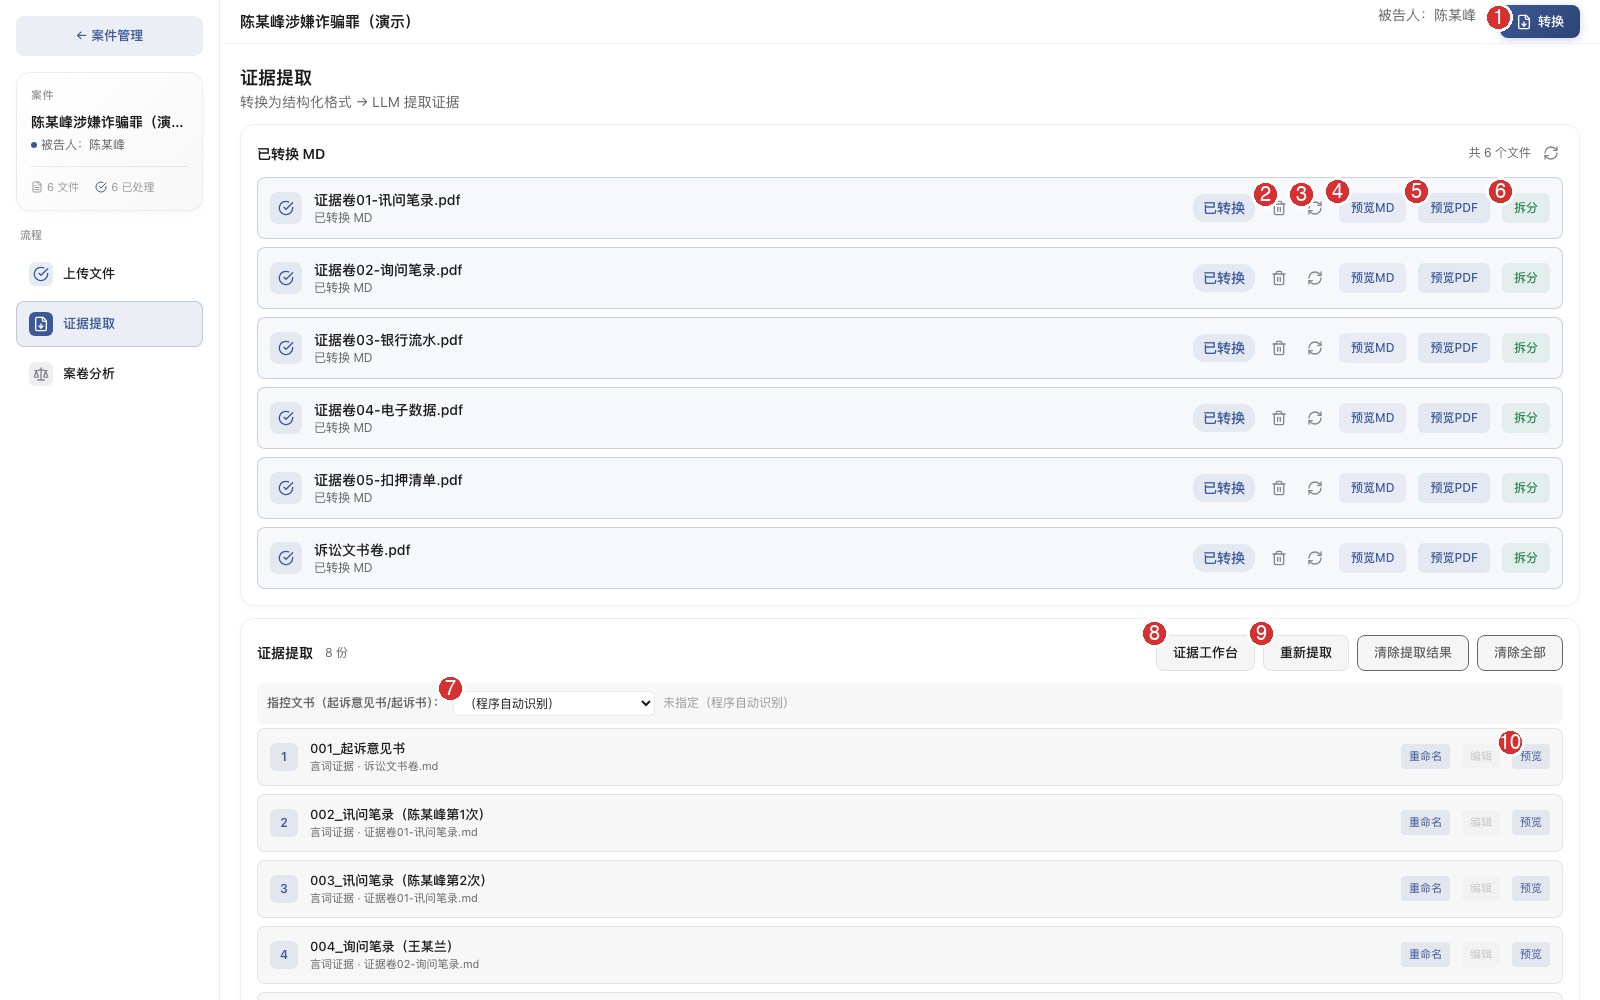
打开案件后进入工作台。左侧为案件信息与流程导航(上传文件 → 证据提取 → 案卷分析,已完成步骤打勾),三步产物依次衔接:PDF 原件 → Markdown 结构化文本 → 证据条目与分析报告。
4.1 第一步:上传文件
接收卷宗 PDF 扫描件,支持批量添加,并在入库前做可选的解密 / 去水印预处理(检察卷常有密码保护)。
4.2 PDF 预览器
全屏 PDF 阅读器,供随时回看卷宗原貌。左侧缩略图导航,右侧缩放与适配控制;预览图与页图带本地缓存,二次打开瞬时呈现。支持页码跳转与文档内全文检索。
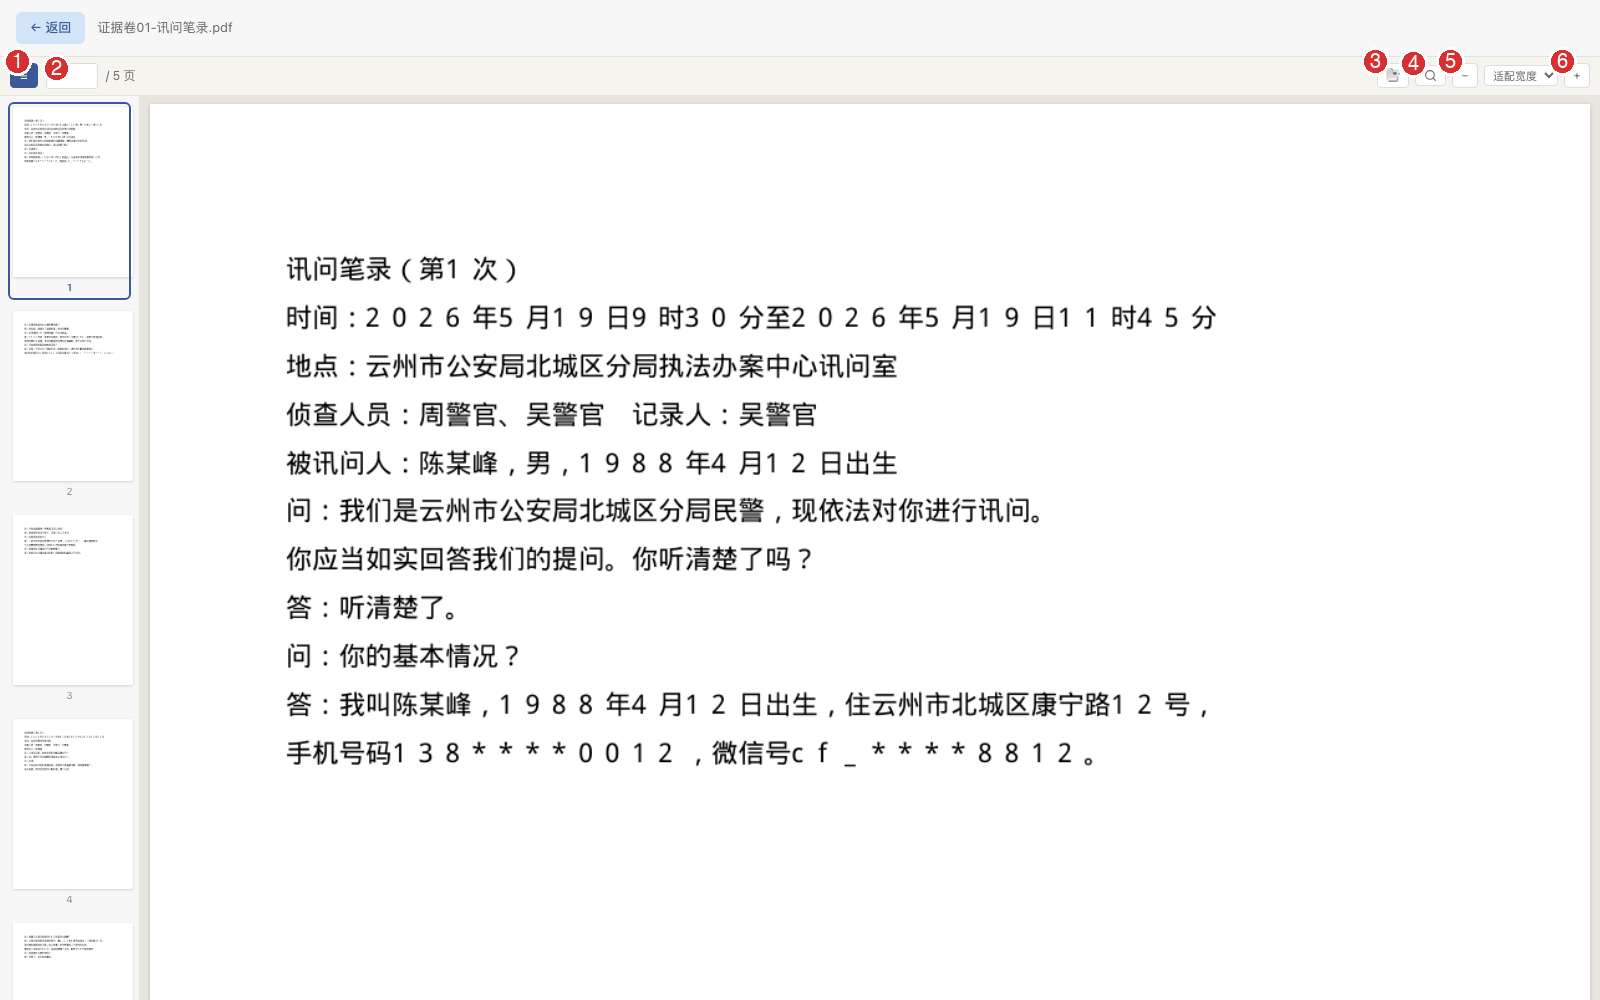
4.3 页面管理与 PDF 拆分
在预览器右上角点「📑 页面管理」进入缩略图网格管理模式——完成两类「卷宗手术」:页面调整(旋转倒置页、删除空白/无关页)与物理拆分(大卷化小、按证据分件)。有识别异常页时入口按钮带 ⚠️ 徽标。
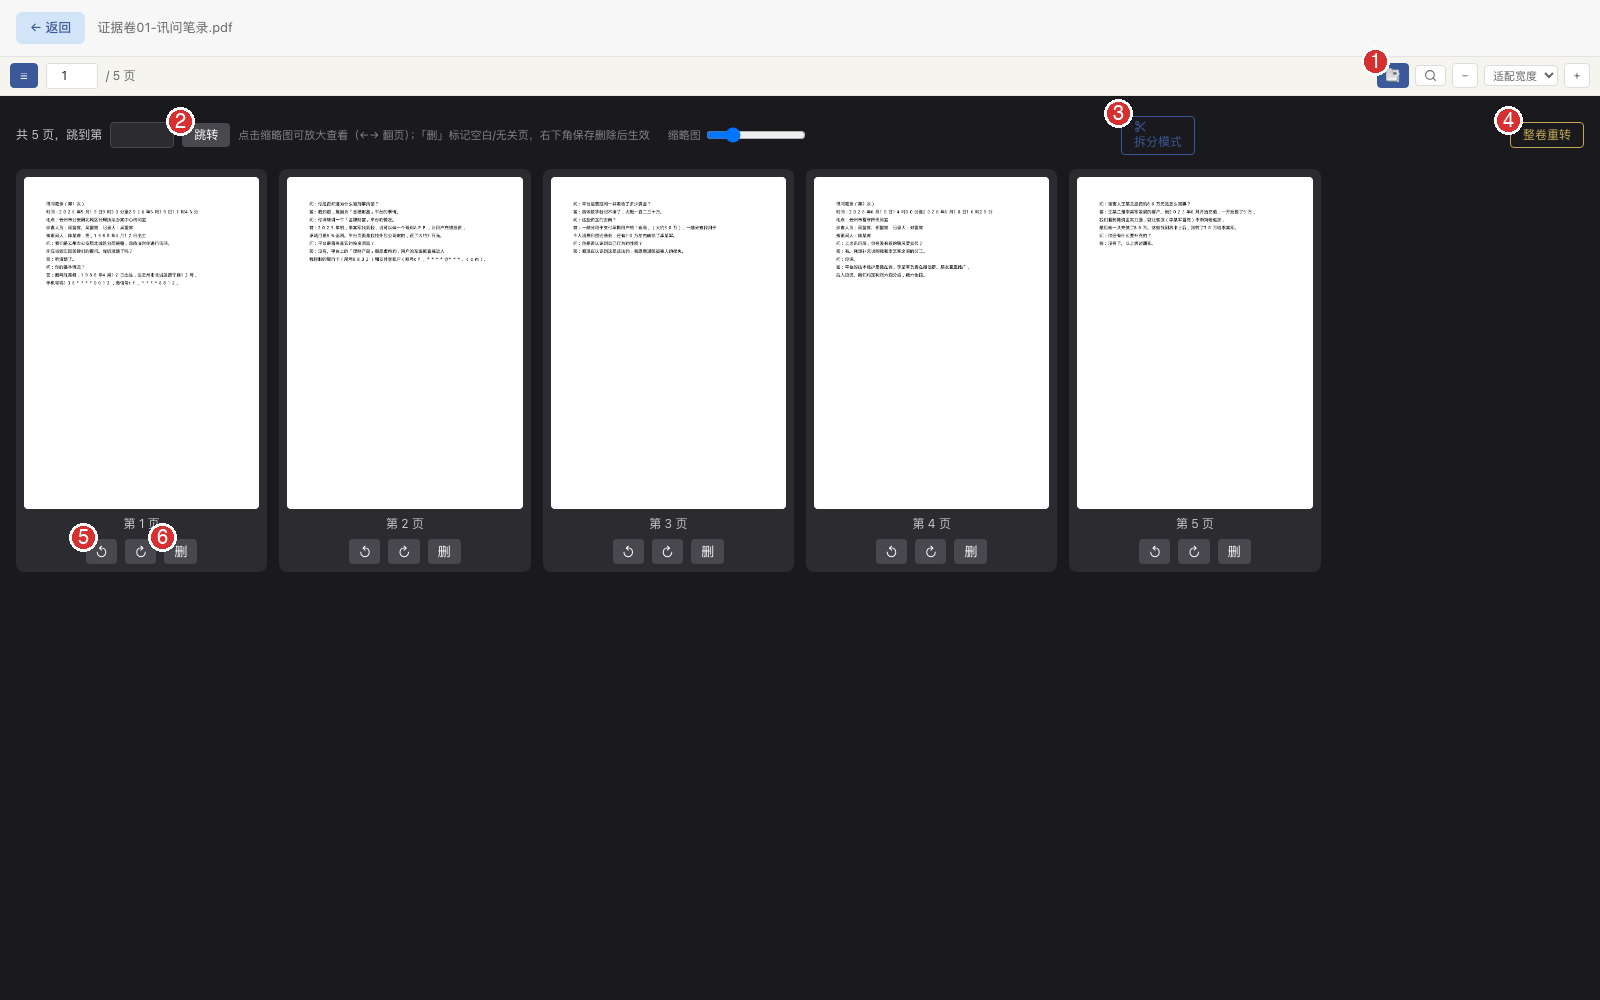
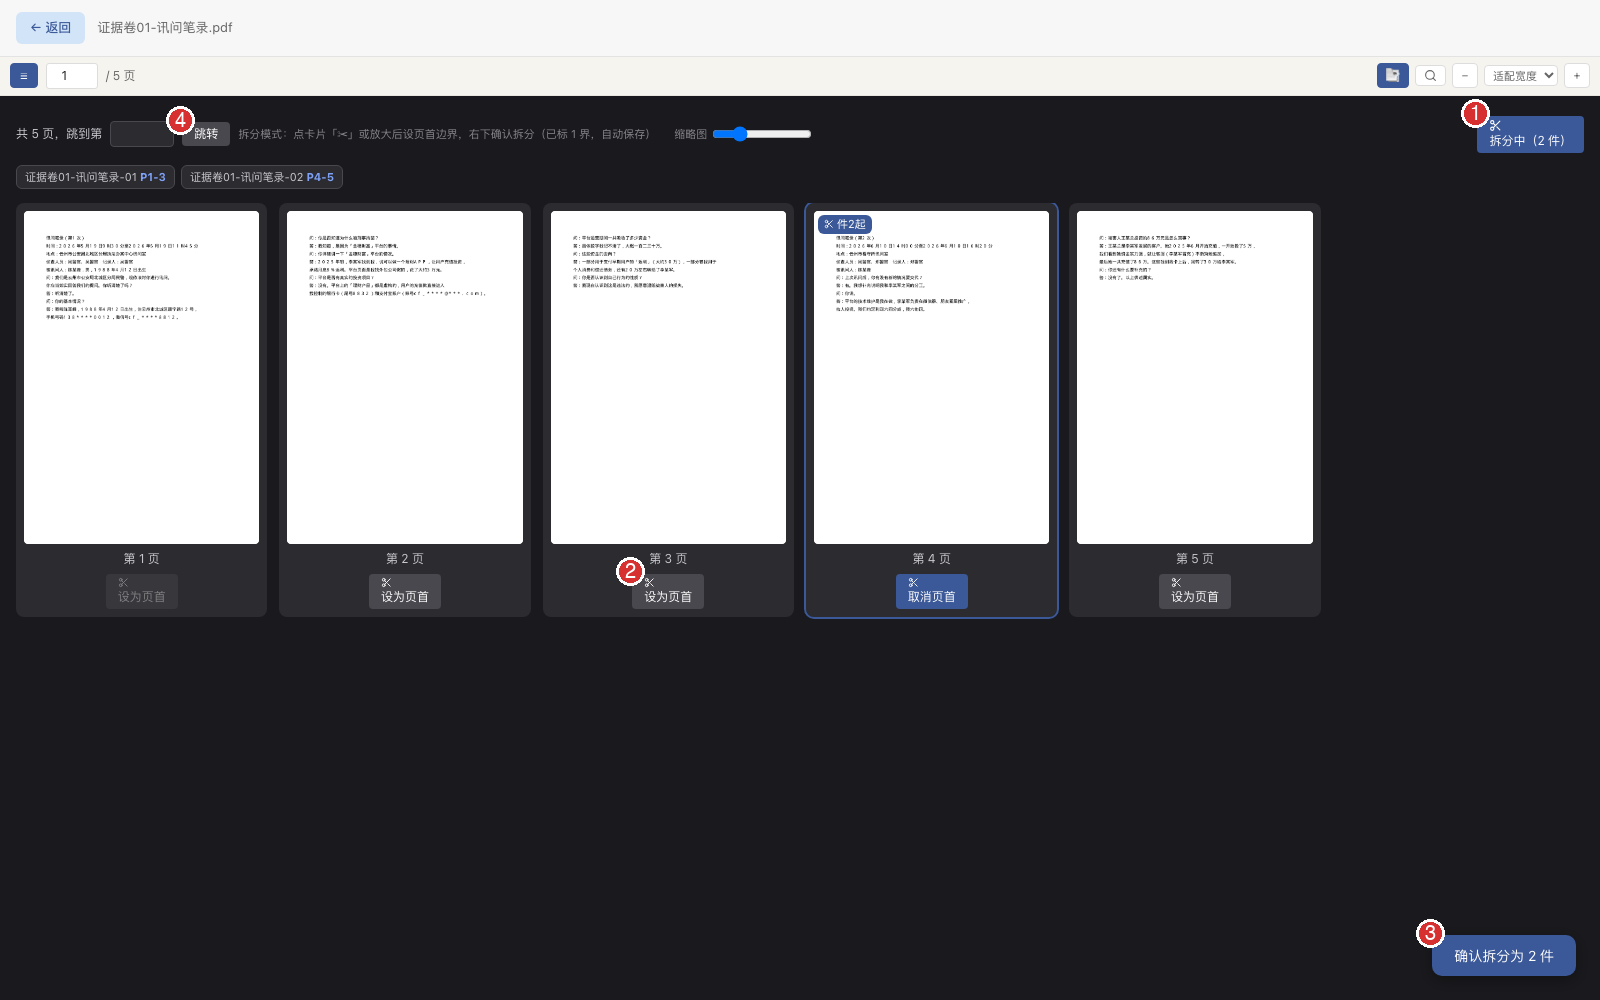
_delbak/,删页后该卷 MD 自动重建,已提取证据失效需重新划界提取。PDF 拆分(拆分模式)
拆分的两个作用:① 按证据拆件——一份证据一件,转换、摘要、提取都以件为单位,边界最干净;② 大文件降容——规避引擎 200MB 限制、缩短单件耗时。逐页「设为页首」定边界,顶部实时预览将拆出的件名与页区间,边界草稿自动保存。
4.4 第二步:证据提取
本步完成两件事:① 将 PDF 批量转换为结构化 Markdown(引擎可选 MinerU 本地/云端或 PaddleOCR-VL,见 7.2);② 由 LLM 从全卷中拆分、命名证据条目并生成摘要。可指定指控文书(起诉意见书/起诉书)作为「指控要素拆解」基准。
4.5 证据工作台
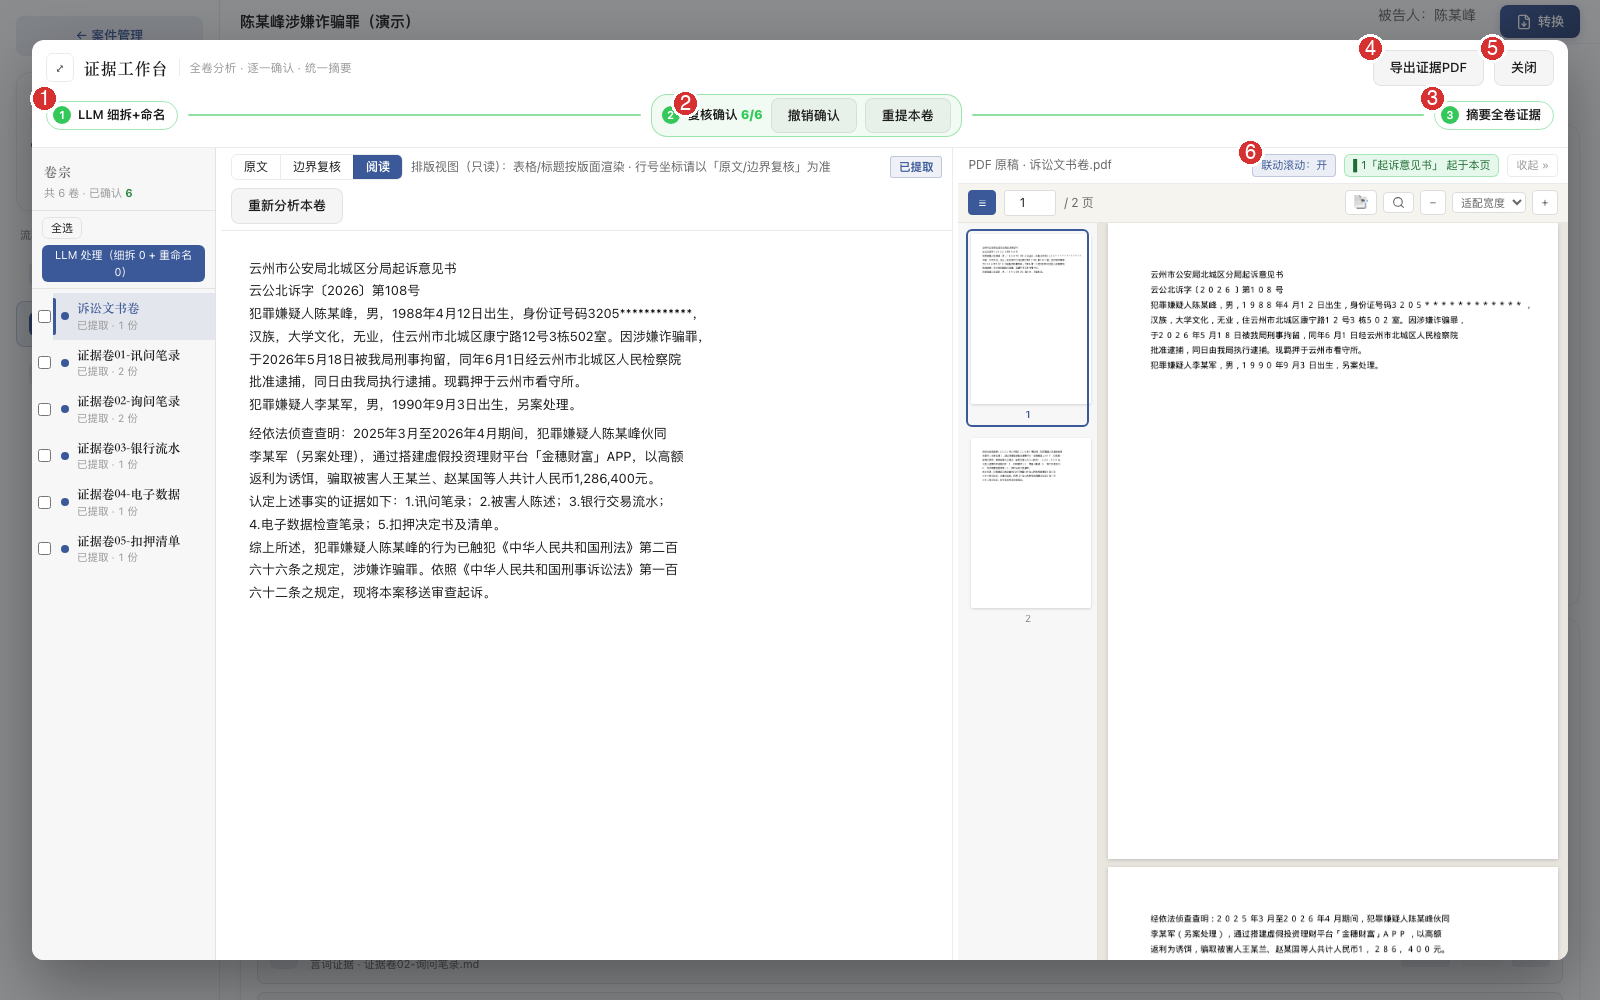
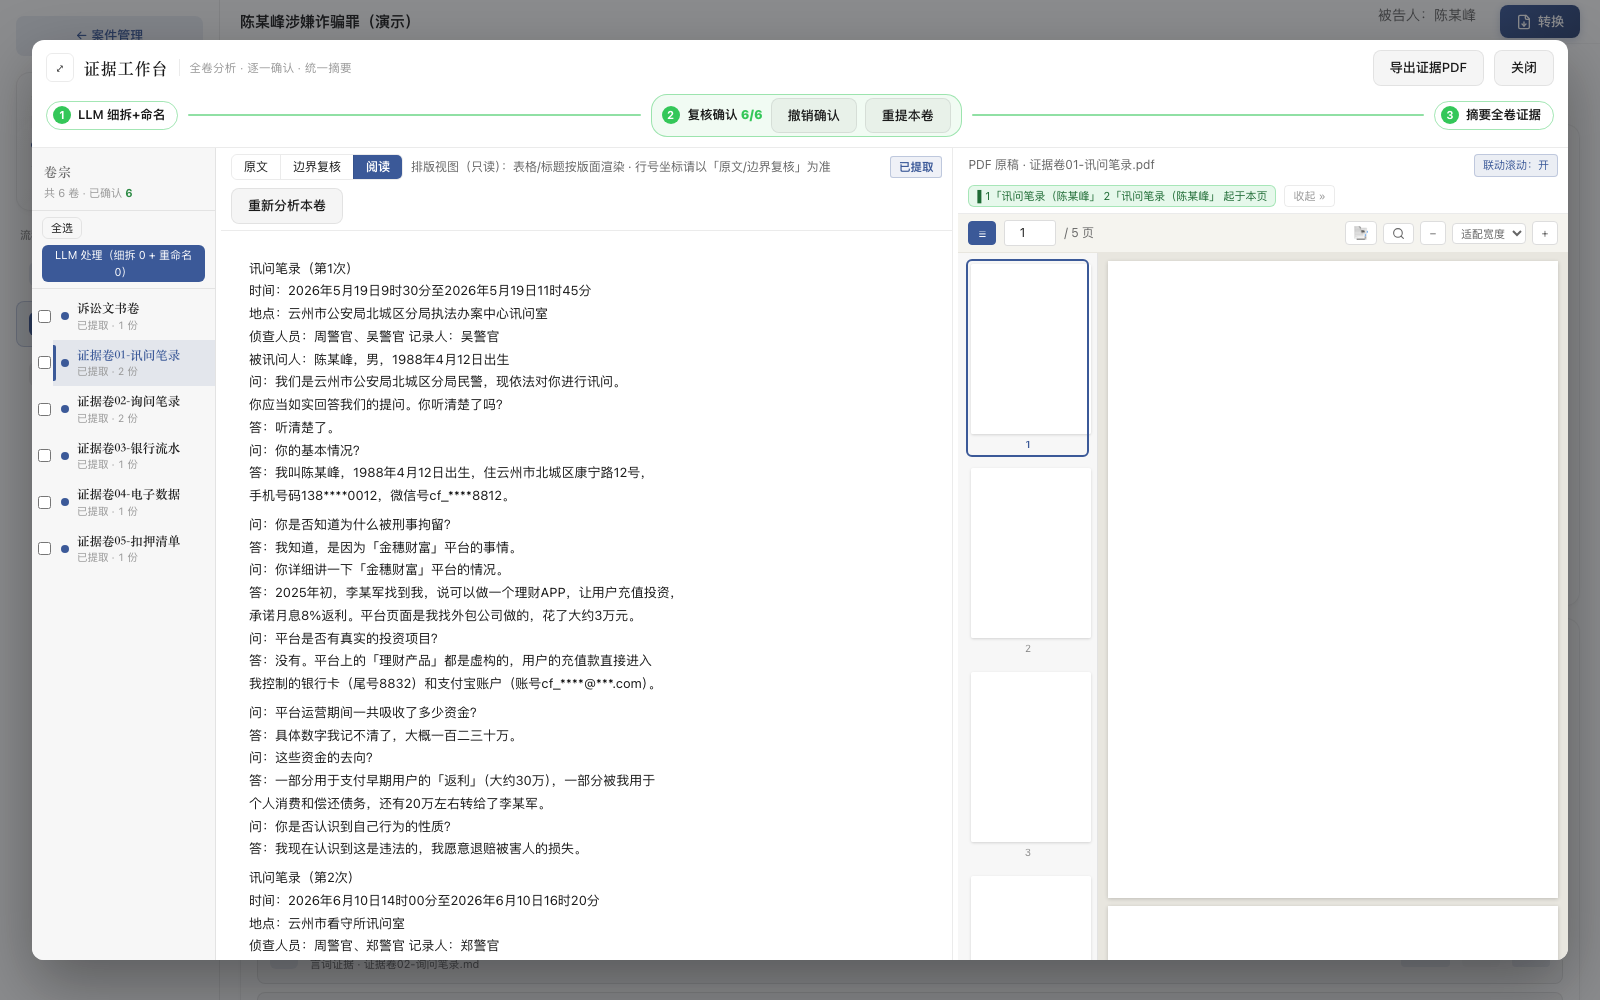
证据质量的核心把关界面,全屏三栏联动:左栏卷宗清单(含提取状态),中栏结构化文本(原文 / 边界复核 / 阅读三种视图),右栏 PDF 原稿(与文本联动滚动,行号级对照)。顶部为三段式流水线:① LLM 细拆+命名 → ② 复核确认 → ③ 摘要全卷证据。
| 控件 | 类型 | 功能说明 |
|---|---|---|
| ① LLM 细拆+命名 | 流水线按钮 | 对勾选卷执行 LLM 证据细拆:识别每份证据的起止边界并自动命名 |
| ② 复核确认 n/n | 流水线状态 | 人工逐卷确认拆分结果,全部确认后进入摘要环节 |
| ③ 摘要全卷证据 | 流水线按钮 | 对已确认的全部证据生成结构化摘要(概述/指控关联/主观明知/获利分账/矛盾提示) |
| ④ 导出证据PDF | 按钮(右上) | 将全部证据条目合并导出为一个 PDF(归档/随卷使用) |
| ⑥ 联动滚动 | 开关(右栏) | 开启后滚动文本时 PDF 原稿自动翻到对应页 |
4.6 证据预览与对照编辑
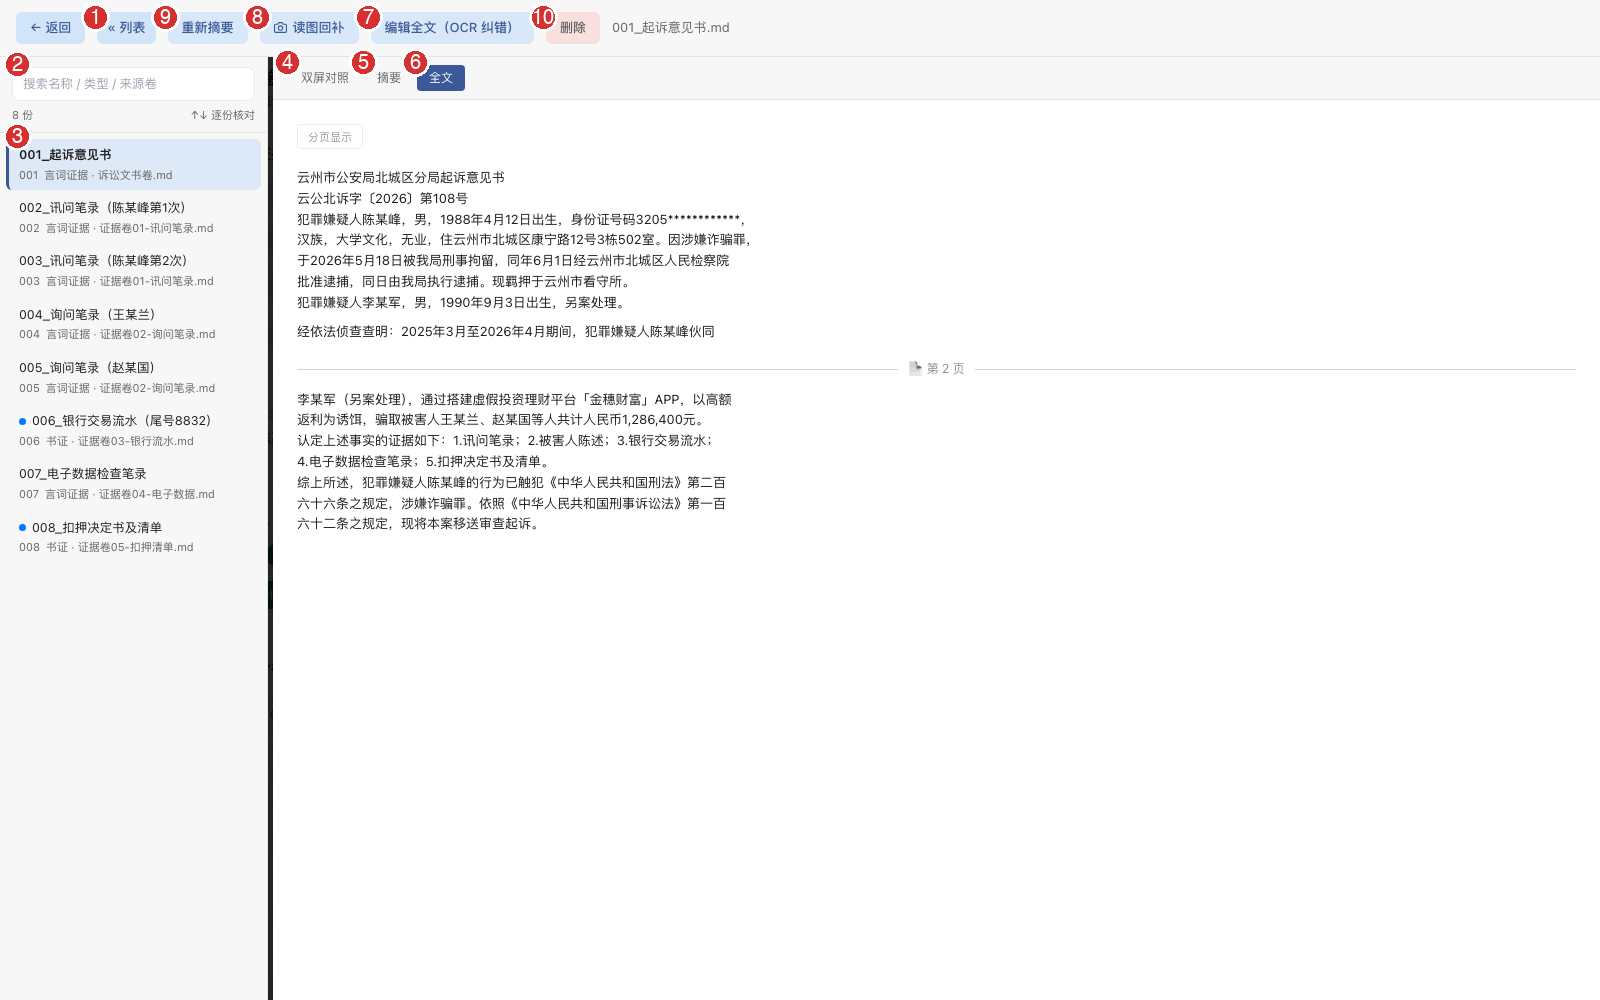
证据行的「预览」打开证据预览界面——法庭质证的核心工具:开庭时按关键词秒级检索证据,当场把证据全文与原件 PDF 并排对照。三栏布局:左栏证据列表(实时过滤,↑/↓ 键切换);中栏全文 ↔ 来源卷 PDF 双屏对照(中缝可拖宽、页码联动);右栏结构化摘要。
MD 对照 PDF 编辑(OCR 纠错)
点「编辑全文(OCR 纠错)」进入左 PDF | 右可编辑文本的纠错模式:只改识别错字(金额、日期、姓名务必人工核对原件),保存写回来源卷对应切片(原卷自动备份 .bak),随后「重新摘要」同步摘要。
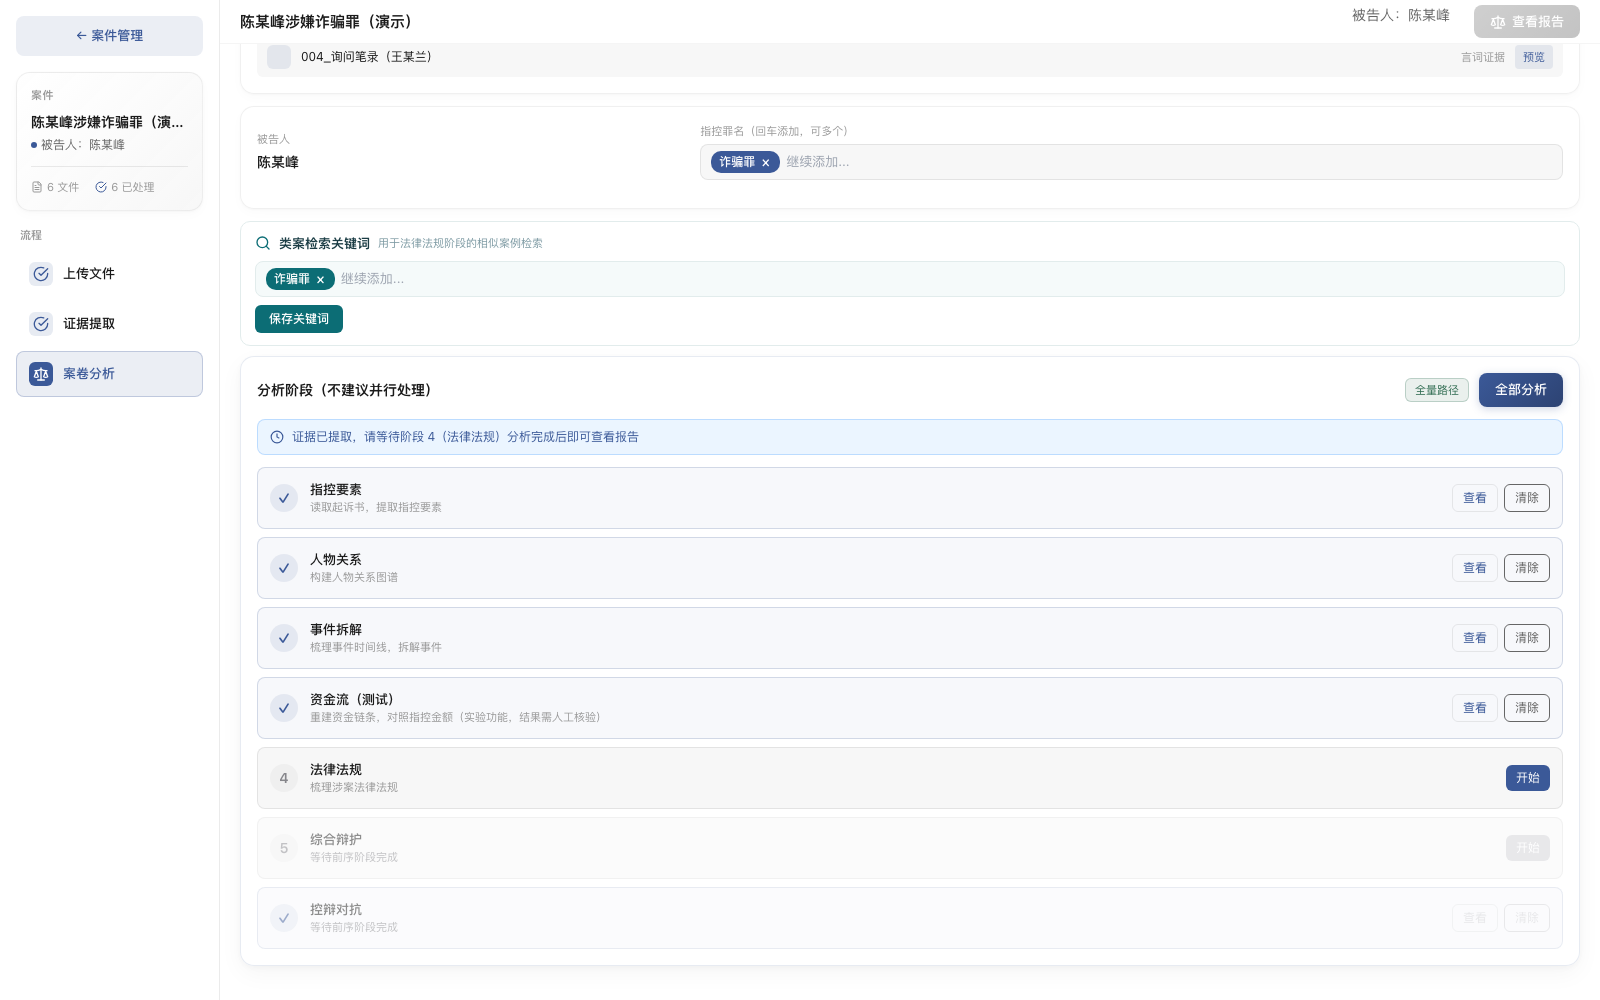
4.7 第三步:案卷分析
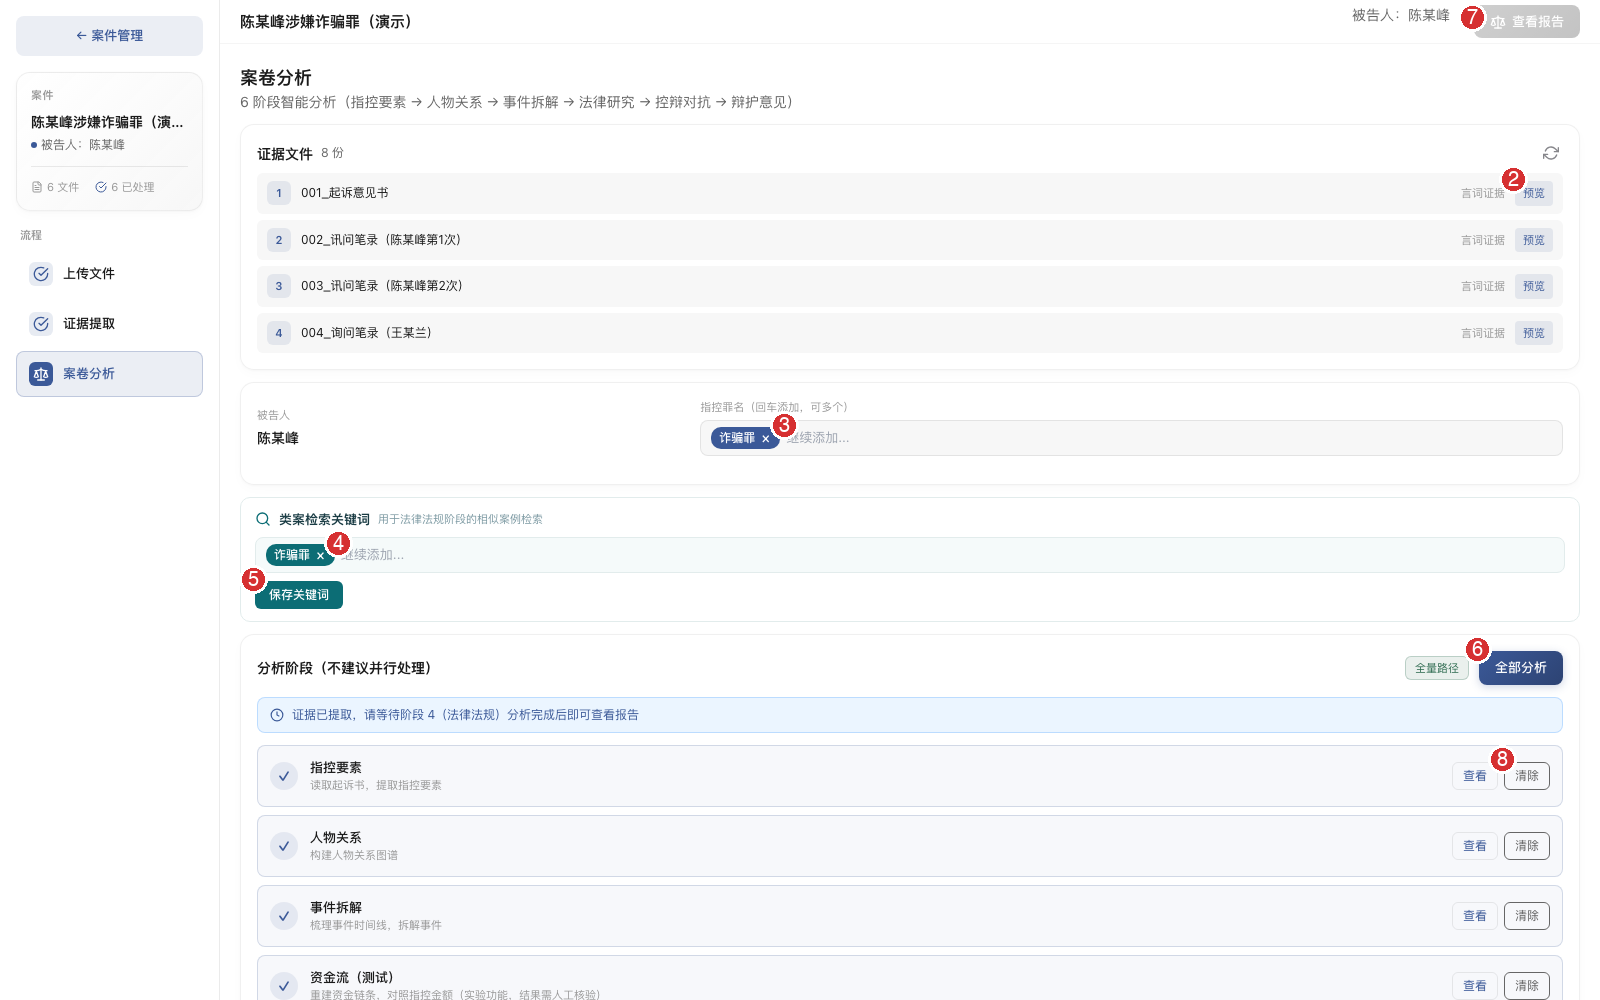
全案的智能分析中枢。上部管理被告人与指控罪名、类案检索关键词;下部为分析阶段流水线,各阶段顺序执行,每阶段产物均可单独查看、清除、重跑。
5. 辩护报告
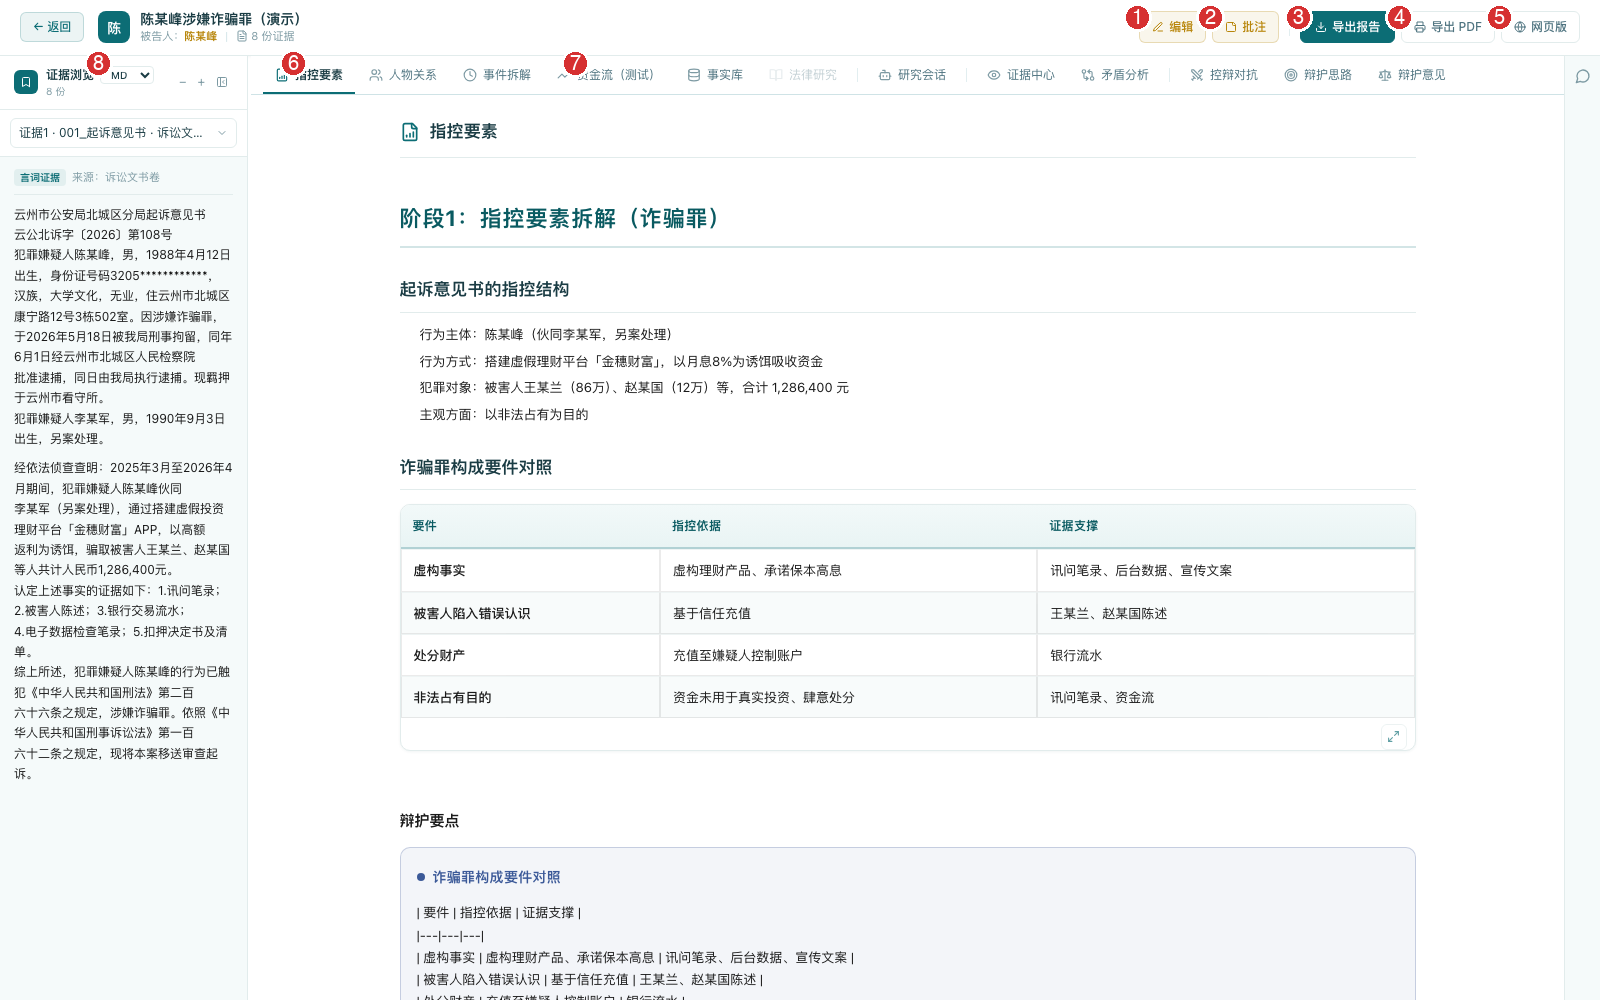
5.1 报告阅读页
全部分析阶段完成后,报告页将各阶段产物组织为一份完整的辩护工作文档。顶部为十二章节导航条,左侧为证据浏览栏(随时对照卷宗原文),中部为报告正文。支持编辑、批注、导出报告 / PDF / 网页版。
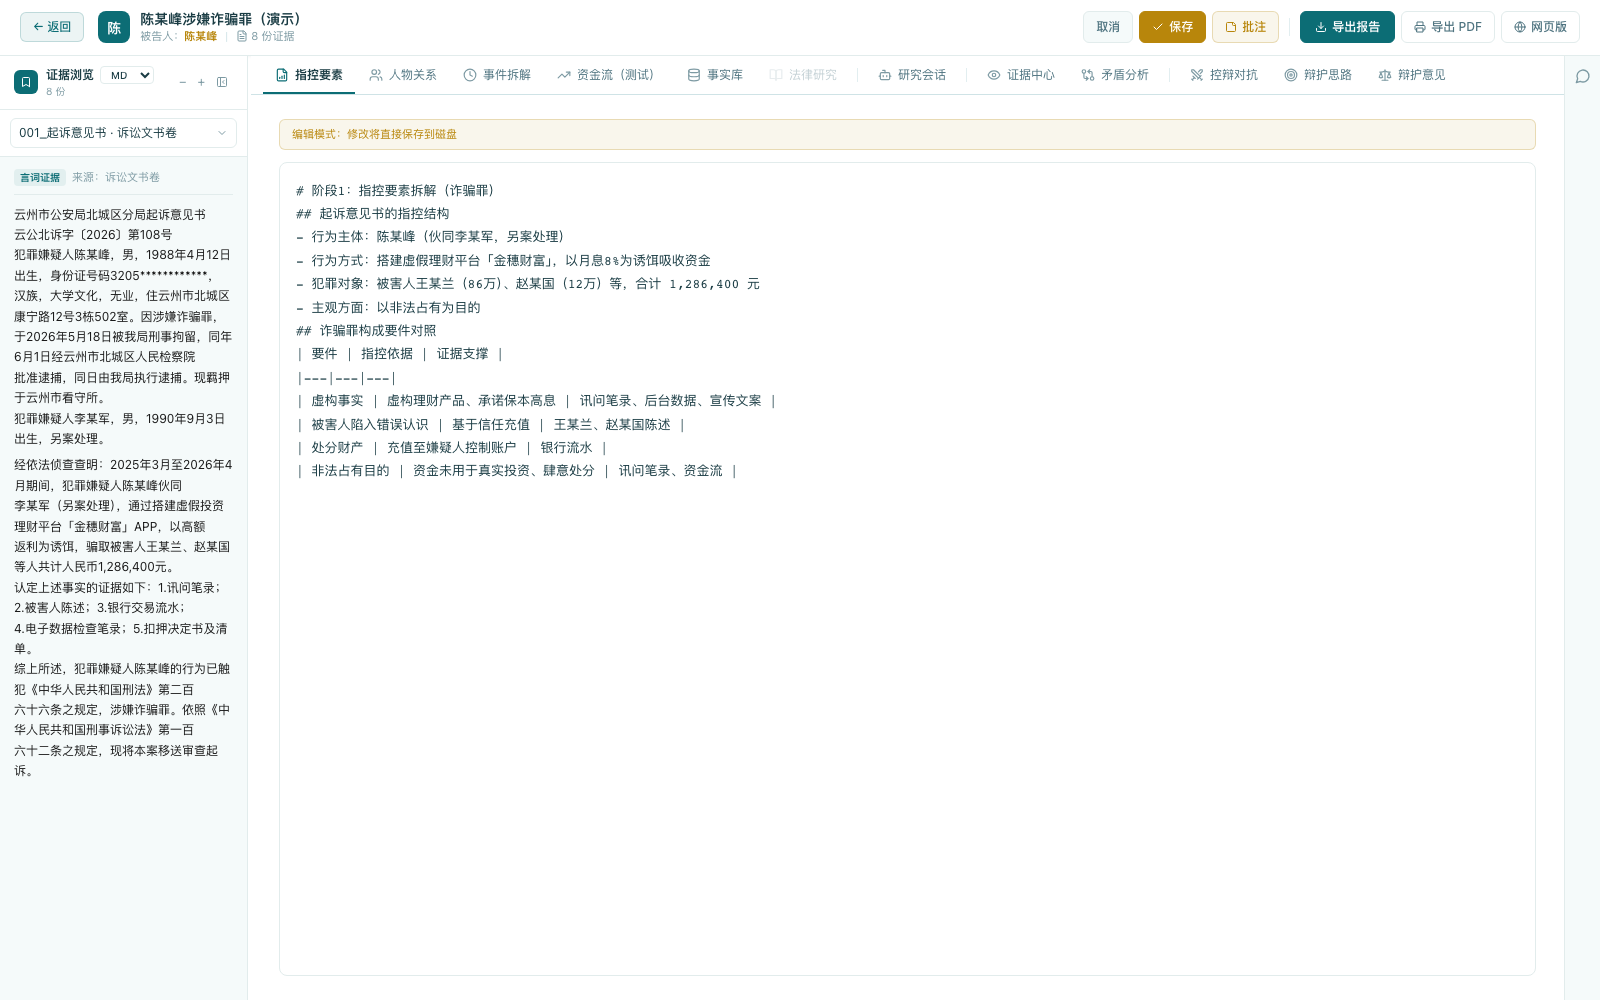
5.2 报告编辑模式
点击「编辑」后正文切换为 Markdown 源码编辑器,律师可直接修订 AI 生成的任何文字——系统明确提示「编辑模式:修改将直接保存到磁盘」。
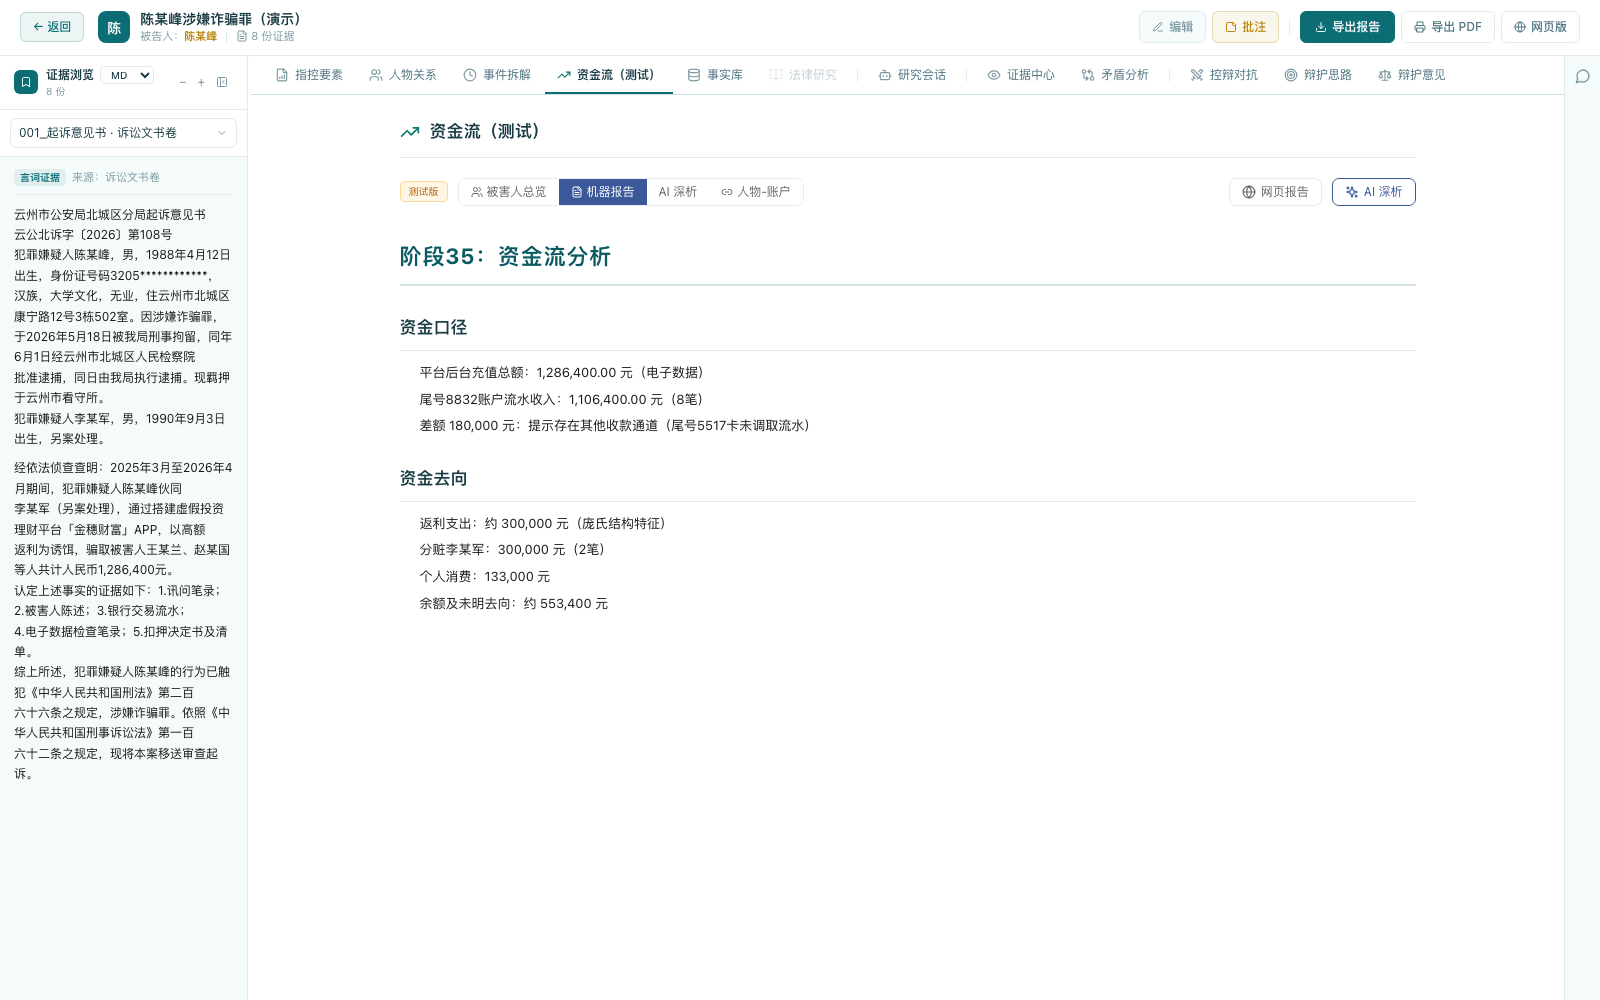
5.3 资金流专项面板
涉众型经济犯罪的核心利器,对应分析阶段 ③.5。四个子页签:被害人总览(按被害人汇总资金线索)、机器报告(资金口径对比、资金去向结构)、AI 深析(LLM 深度归因)、人物-账户(账户名册与关联图谱)。
5.4 人物关系图谱
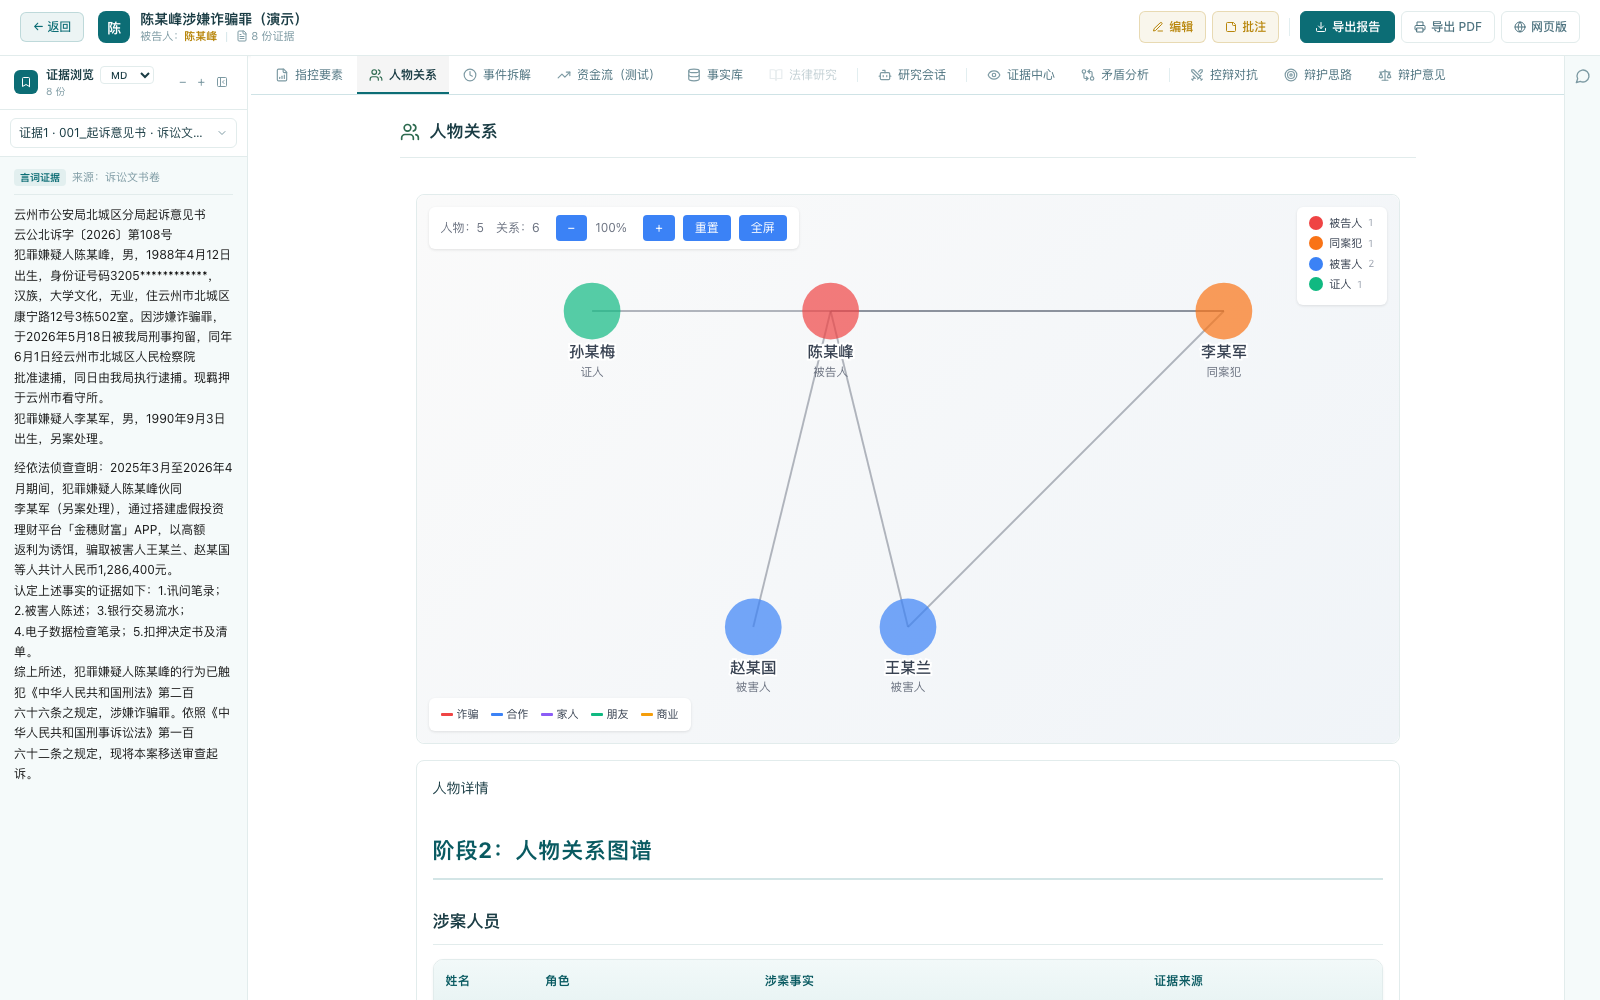
系统从全卷讯问笔录、被害人陈述中自动抽取涉案人员及其相互关系,以 SVG 交互图谱呈现:节点按角色分组着色(被告人红 / 同案犯橙 / 被害人蓝 / 证人绿),连线带方向箭头并标注关系。节点可拖拽摆位、悬停高亮关系、点击弹出详情;图谱下方保留文字版关系报告,图文互证。
6. 法律研究
首页顶栏「法律研究」进入研究中心。其核心是一个内置 AI 研究 Agent:你提出法律问题,Agent 自主完成「分析问题 → 多源检索 → 评分筛选 → 证据建账 → 起草报告」全流程,每一步透明留痕、可展开复核。中心含三个板块:研究会话、争点案头、本地法条库。
6.1 研究会话(AI 研究 Agent)
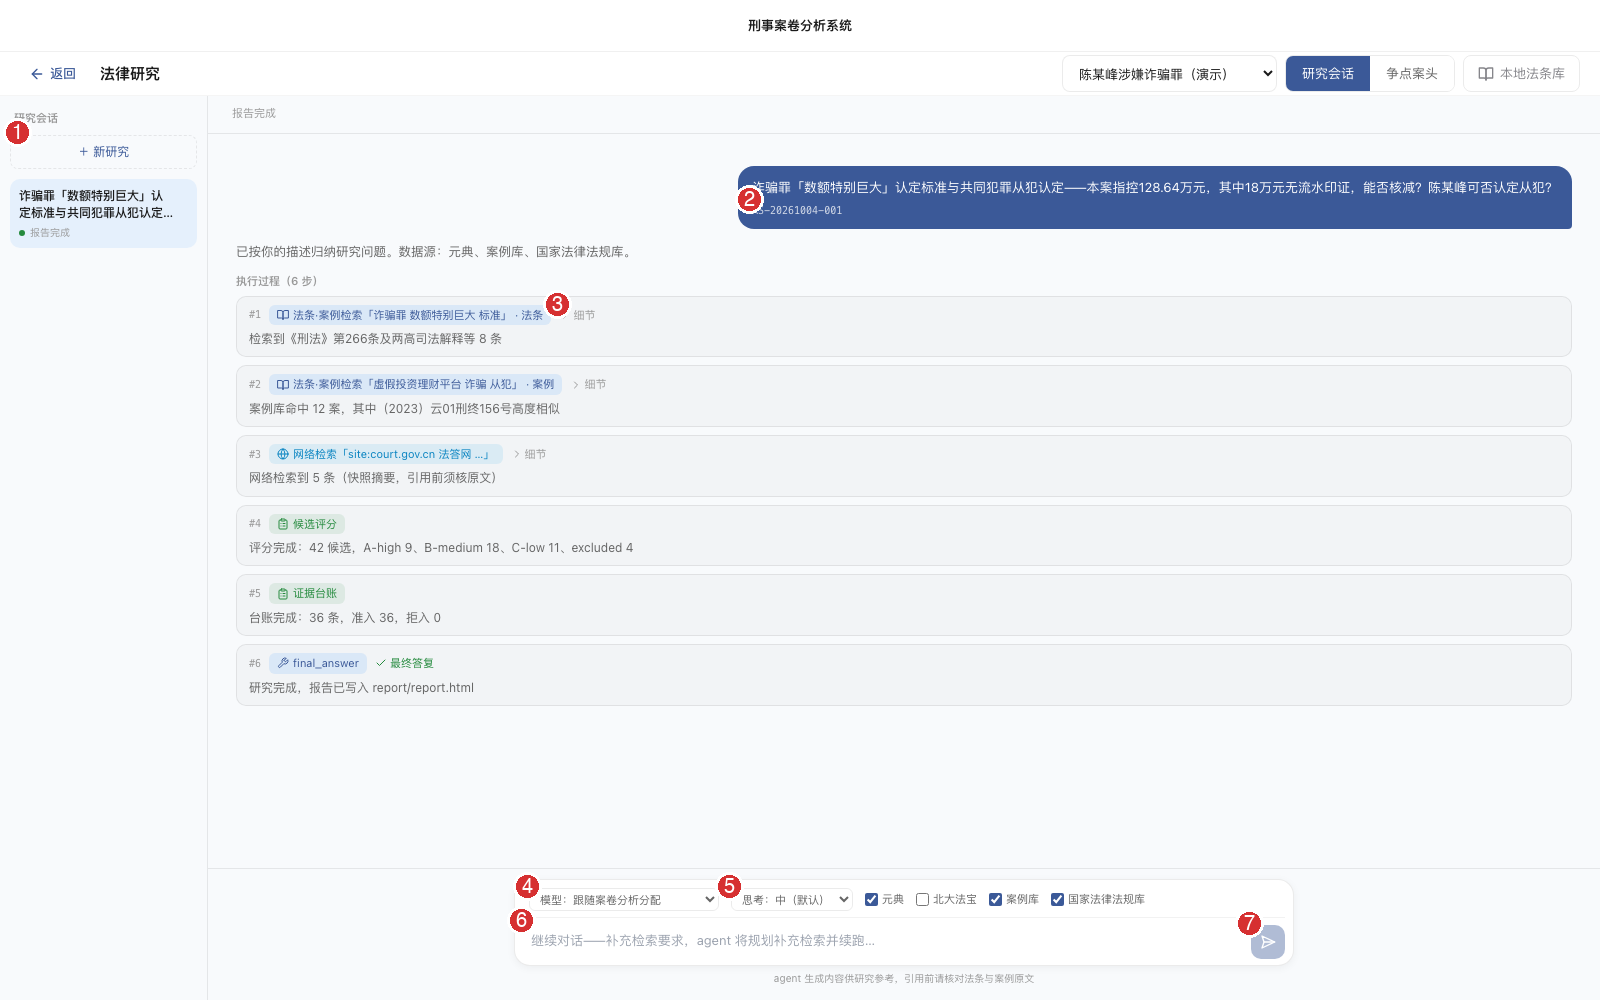
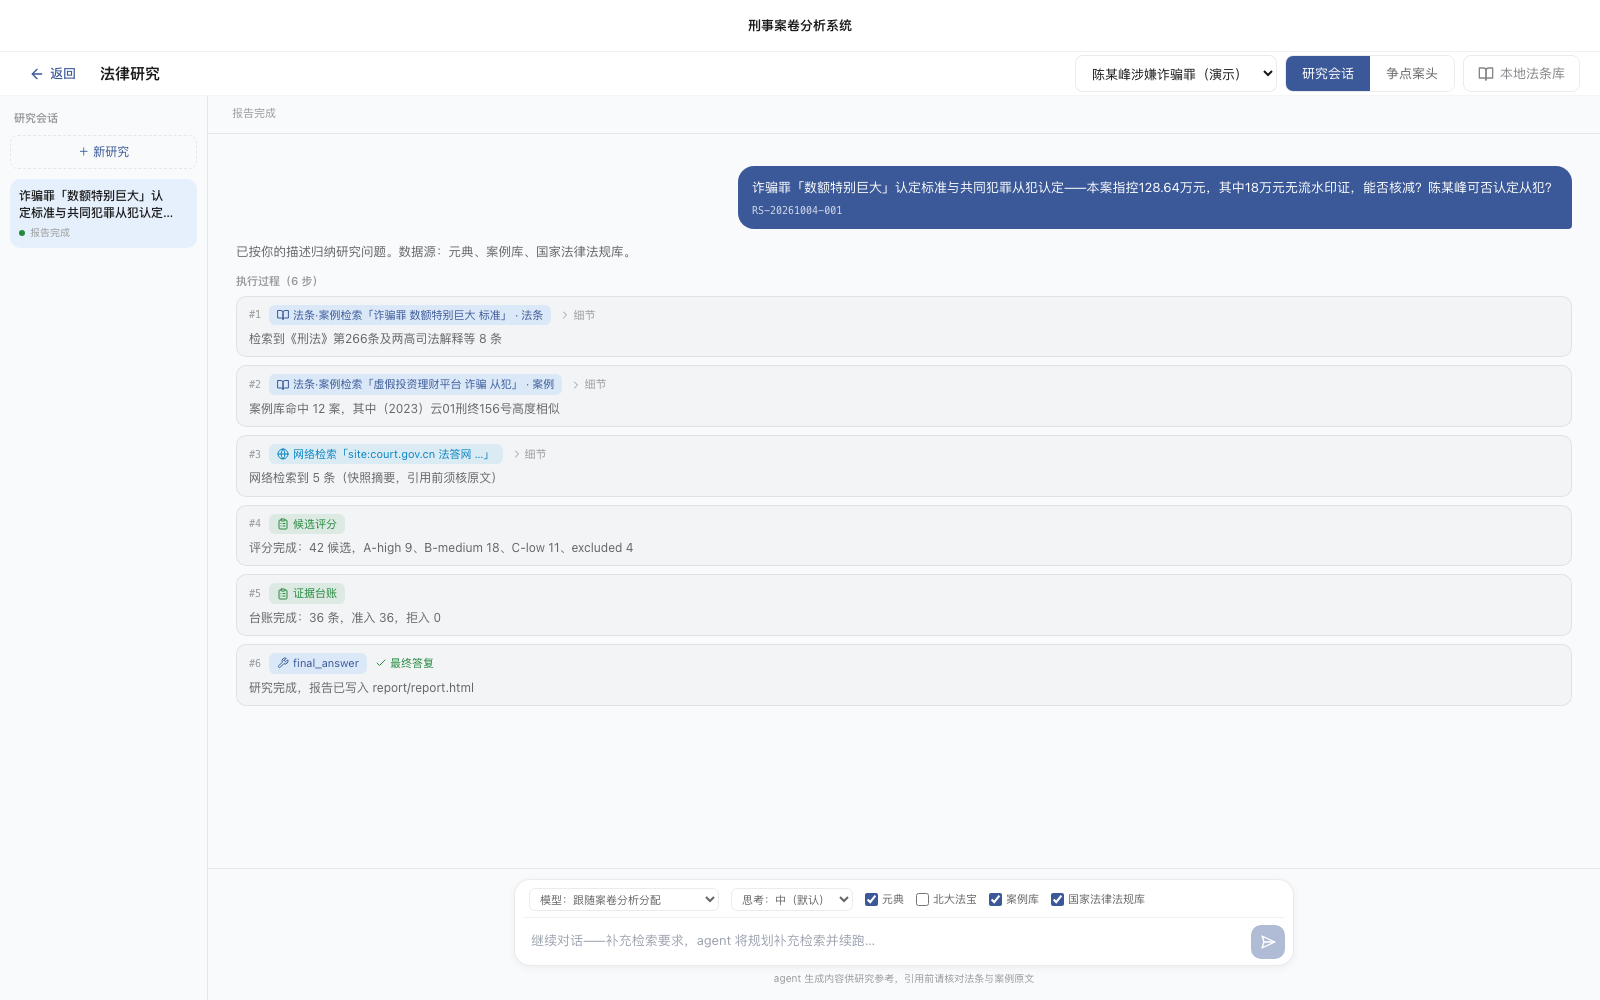
一次研究的标准流程:intake(问题确认卡)——Agent 先做问题分析并执行两轮预检索,向你出示确认卡(问题拆解/拟用数据源/检索计划),确认后才正式执行;检索充实 → 评分台账 → 起草报告三阶段顺序推进;报告以 HTML 落盘归档,可导出 PDF。
6.2 内置技能与数据源
主技能 legal-research 编排完整研究流程(含问题分析/规范检索/案例检索/技术标准检索 4 个子技能);技能之下是 14 个确定性工具,由 LLM 自主调用——LLM 只做判断与生成,检索与建账全部由确定性代码执行,保证过程可复核。
| 数据源 | 形态 | 内容与说明 |
|---|---|---|
| 本地法条库 | 内置 · 离线 | 刑法、刑诉法、司法解释等 8 部全文按条索引;零网络引用前优先,配程序化条号核验(防幻觉闸门) |
| 本地案例母库 | 内置 · 离线优先 | 约 4,883 案,覆盖刑事审判参考、最高法/最高检指导性案例、公报案例等六类官方来源;FTS + 向量混合检索,每日增量补抓 |
| 元典开放平台 | 在线 · 需配 Key | 法条 + 案例语义向量检索,返回观点摘要与裁判要旨 |
| 北大法宝 | 在线 · 需配 Key | 法条 + 案例检索(MCP 通道),与元典同选时交叉核验 |
6.3 研究报告的辩护引用(整份 / 摘选)
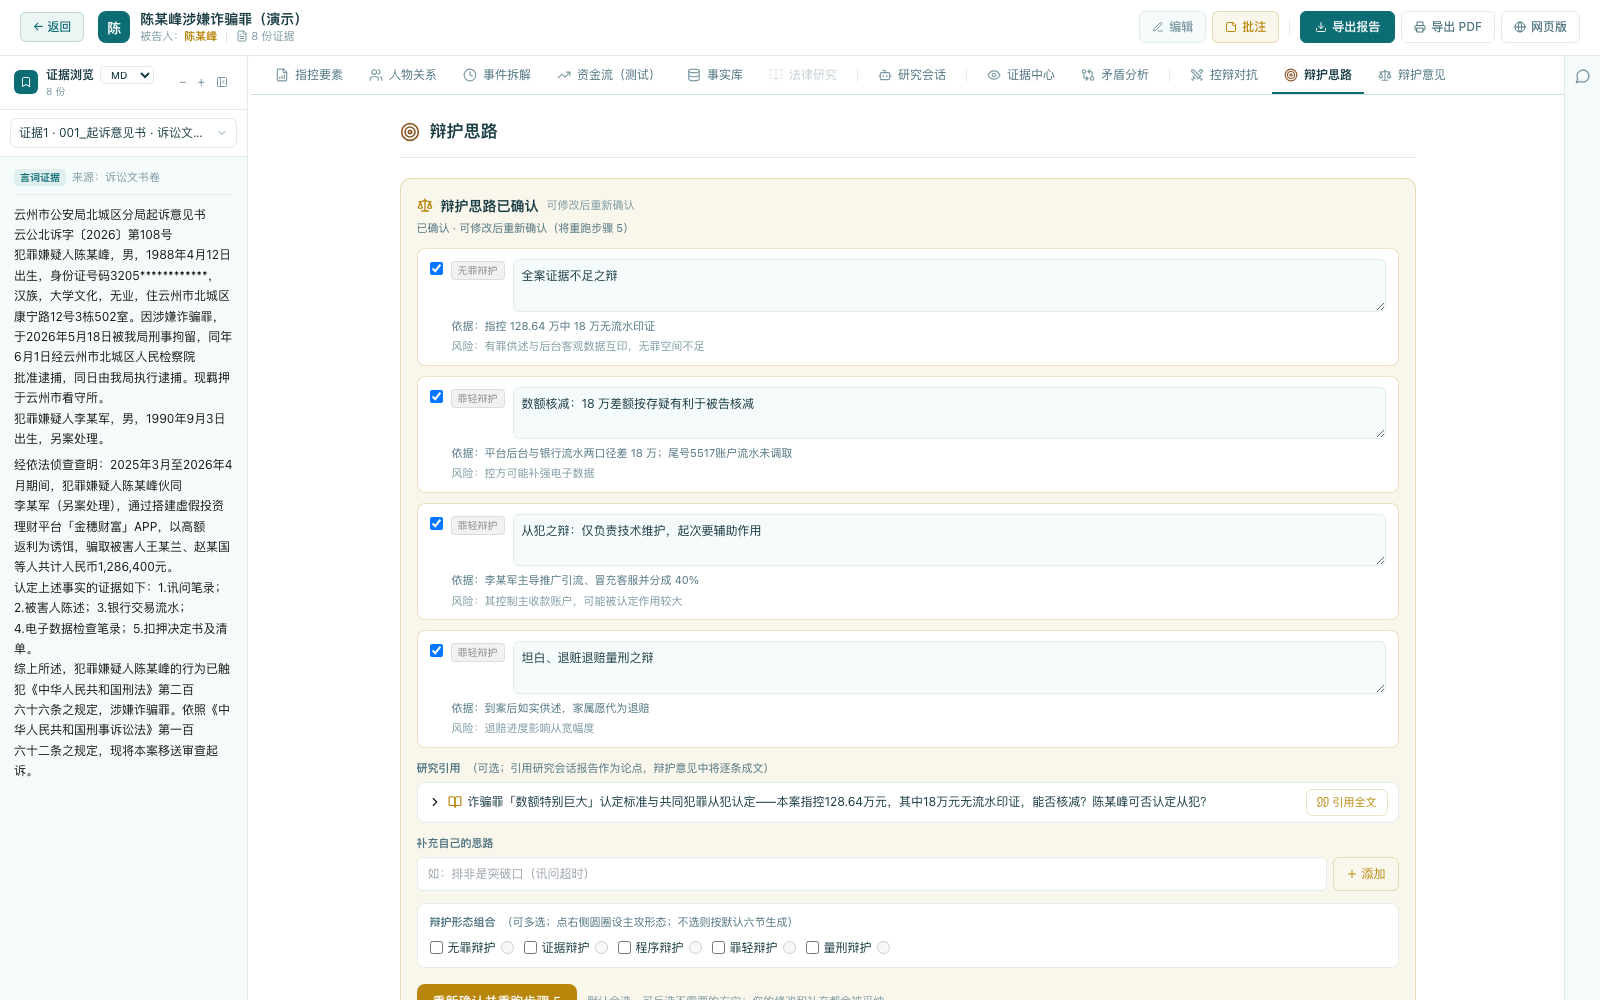
完成的研究报告可以直接引用为辩护论点进入辩护意见书正文。入口在辩护思路确认面板的「研究引用」区:本案全部已完成的研究会话按问题标题列出,可引用全文或在报告预览中划选片段引用(自动蒸馏论点句)。生成辩护意见书时每条引用逐条升格成文为正式论点段落,段末自动加脚注标注来源。
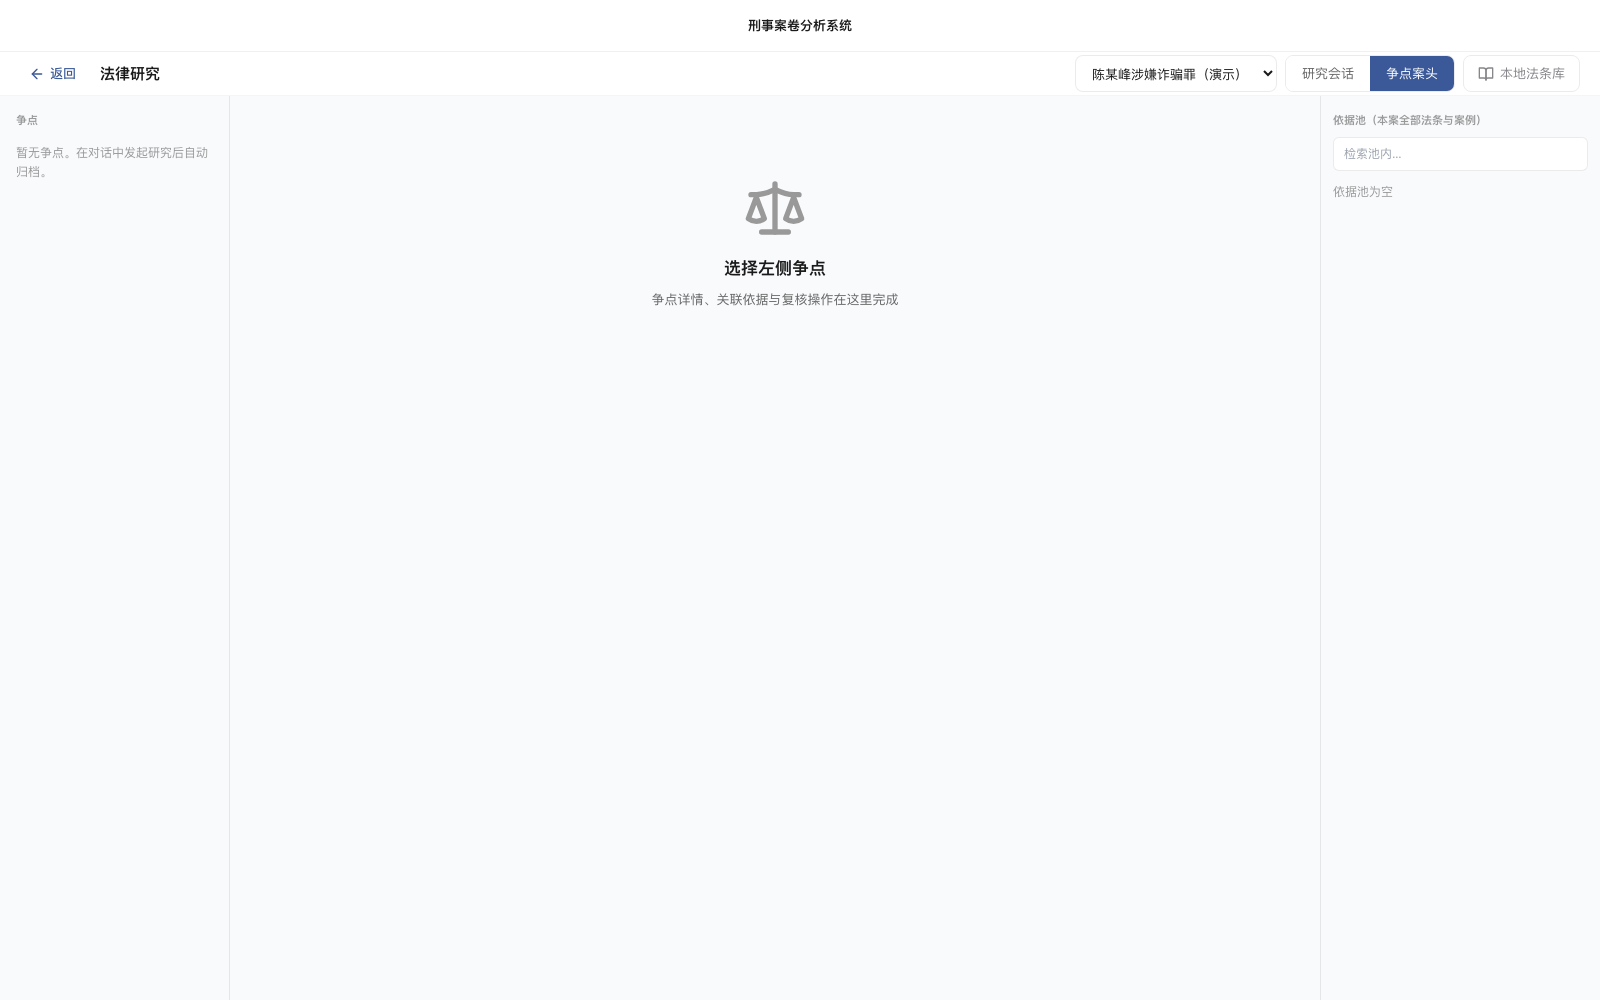
6.4 争点案头
按「争点」组织的研究成果归档板,三栏布局:争点列表 / 争点详情 / 依据池(本案全部法条与案例,支持池内检索)。
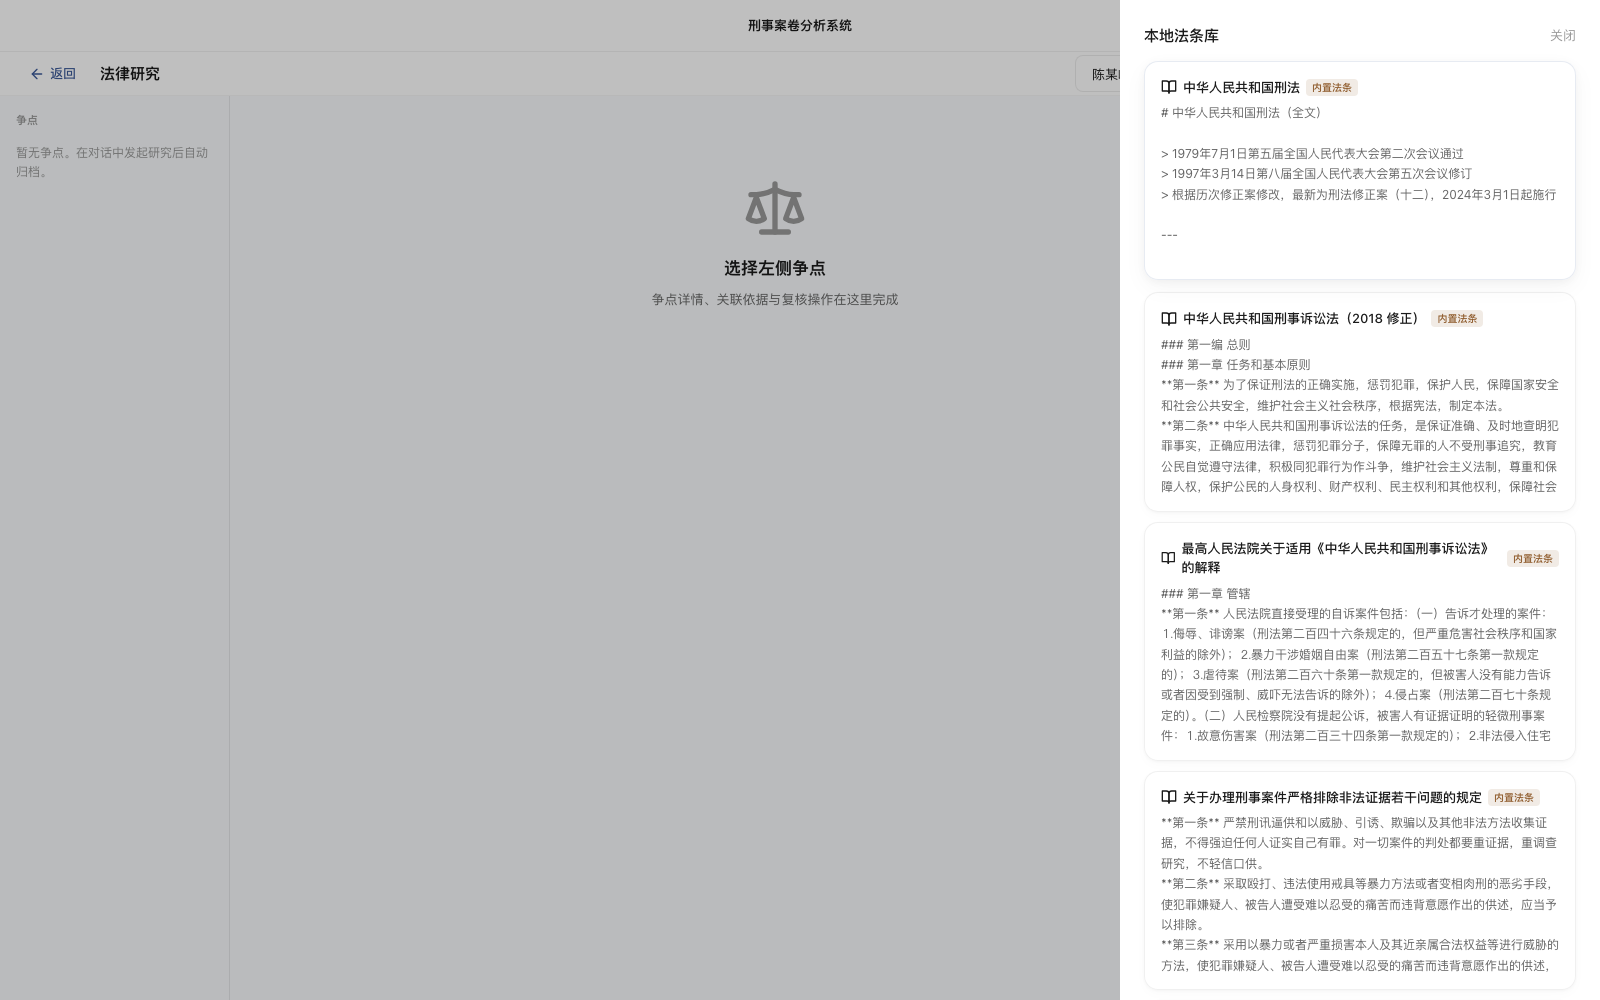
6.5 本地法条库
离线可用的法条速查面板(侧滑打开),内置刑法、刑事诉讼法、刑诉法解释、排非规定等刑事辩护高频法条全文,无需联网、无需 API Key,断网环境照常可用。
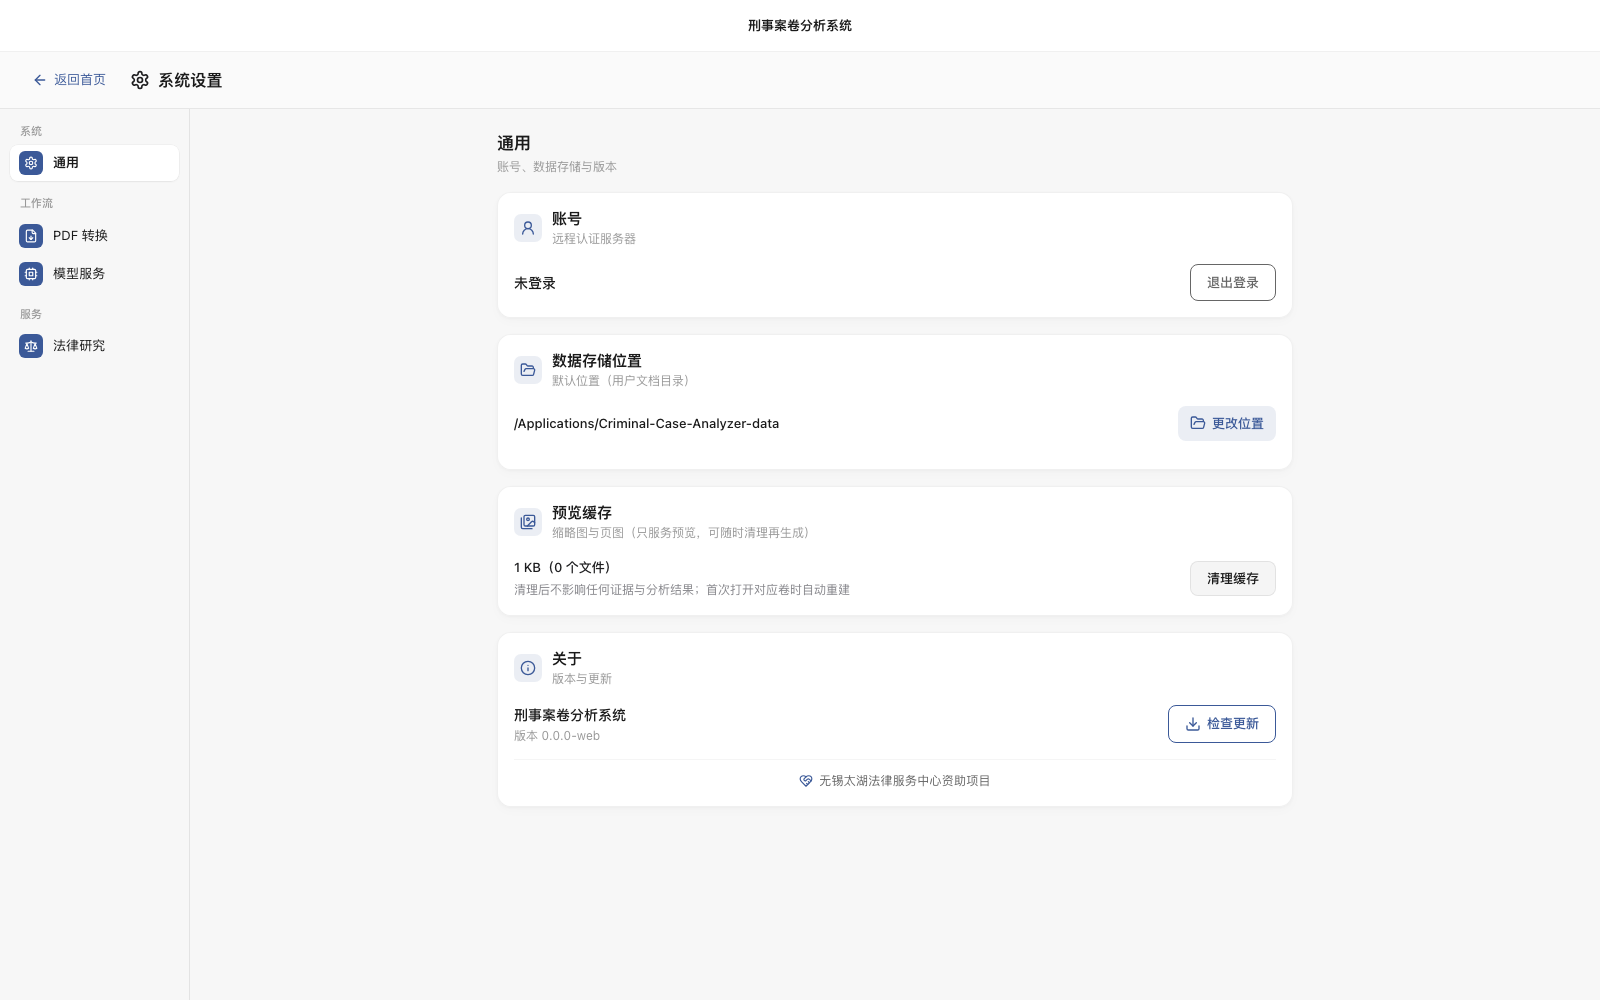
7. 系统设置
左侧分组导航:系统(通用)、工作流(PDF 转换、模型服务)、服务(法律研究)。除特别标注外,改动需点「保存配置」生效。
7.1 通用
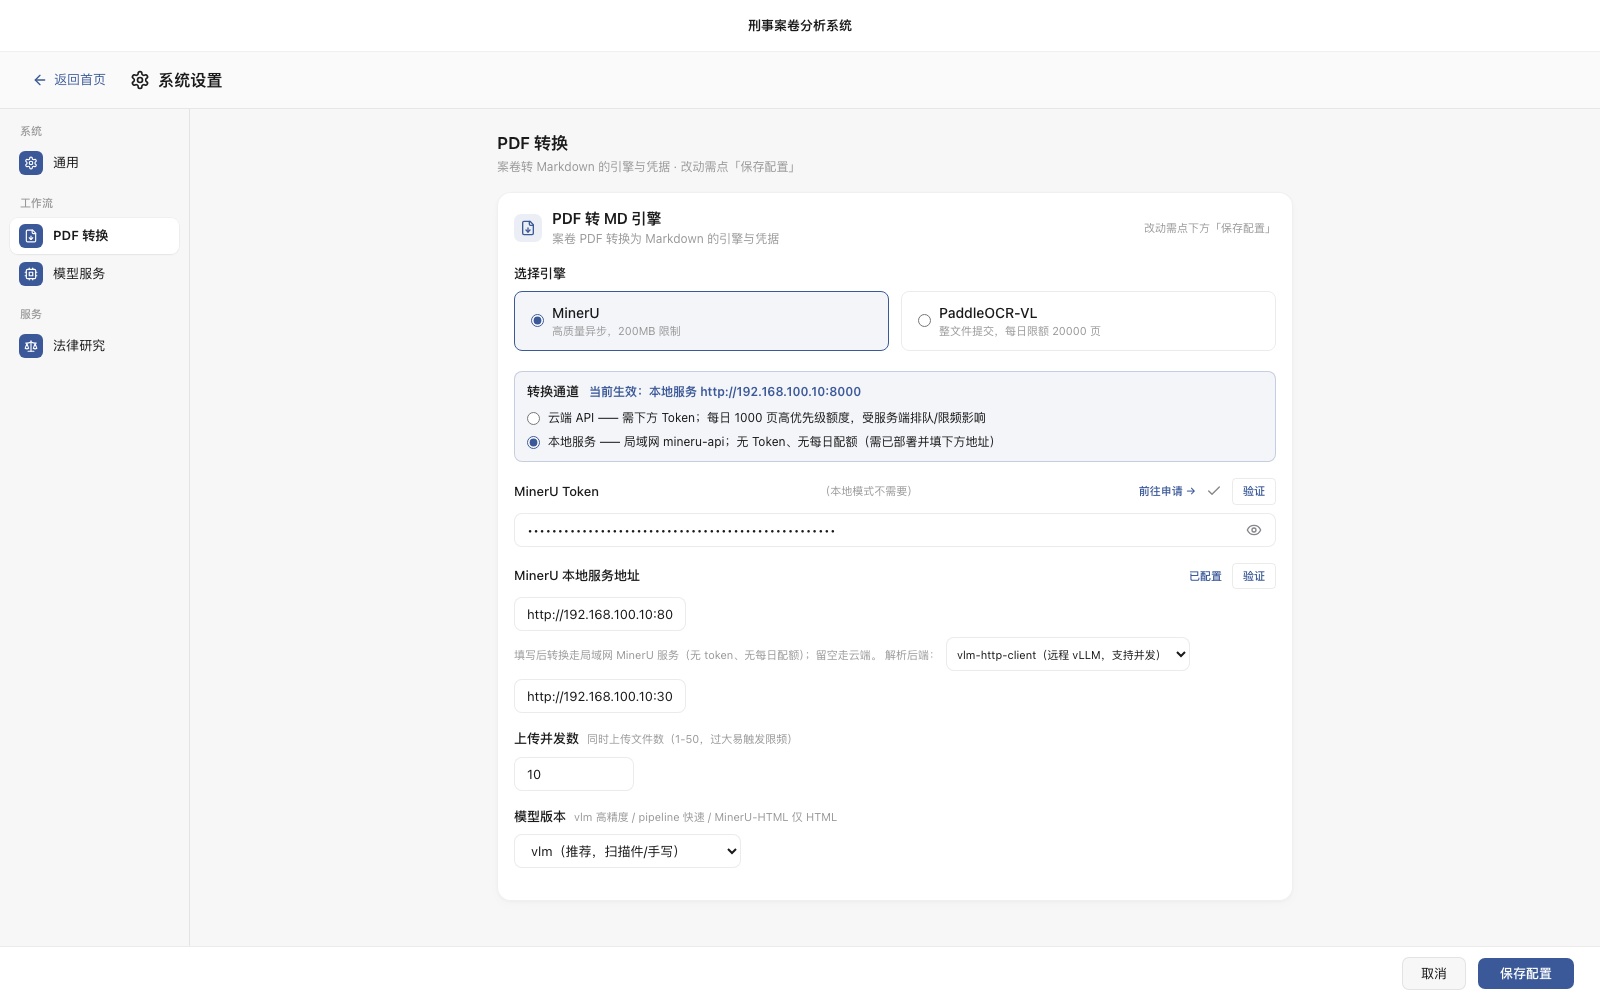
7.2 PDF 转换
引擎二选一——MinerU(可选本地服务或官方云端 API)或 PaddleOCR-VL(云端)。纯内网部署走 MinerU 本地服务即可全离线:无 Token、无每日配额、数据不出内网;云端引擎作为算力补充与配额回退随时可切。
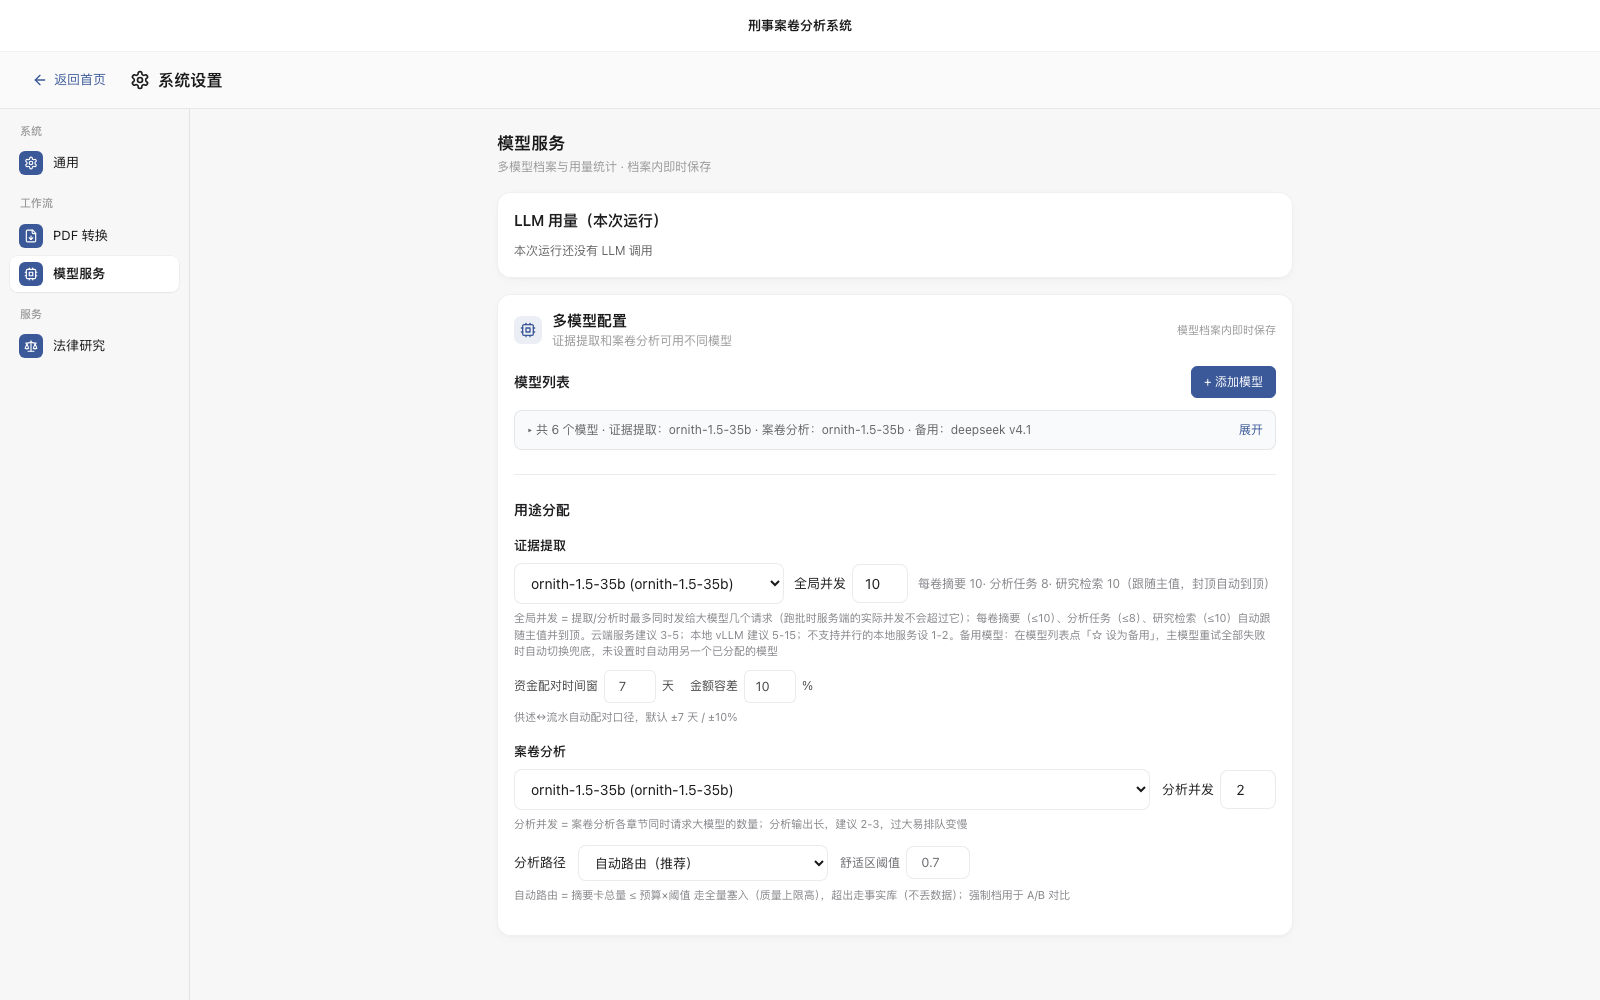
7.3 模型服务
多模型档案与用量统计。默认档案为云端大模型(阿里云百炼),也可登记本地大模型端点(OpenAI 兼容接口,如 DGX Spark 上的 vLLM);证据提取与案卷分析可分配不同模型档案。
7.4 法律研究
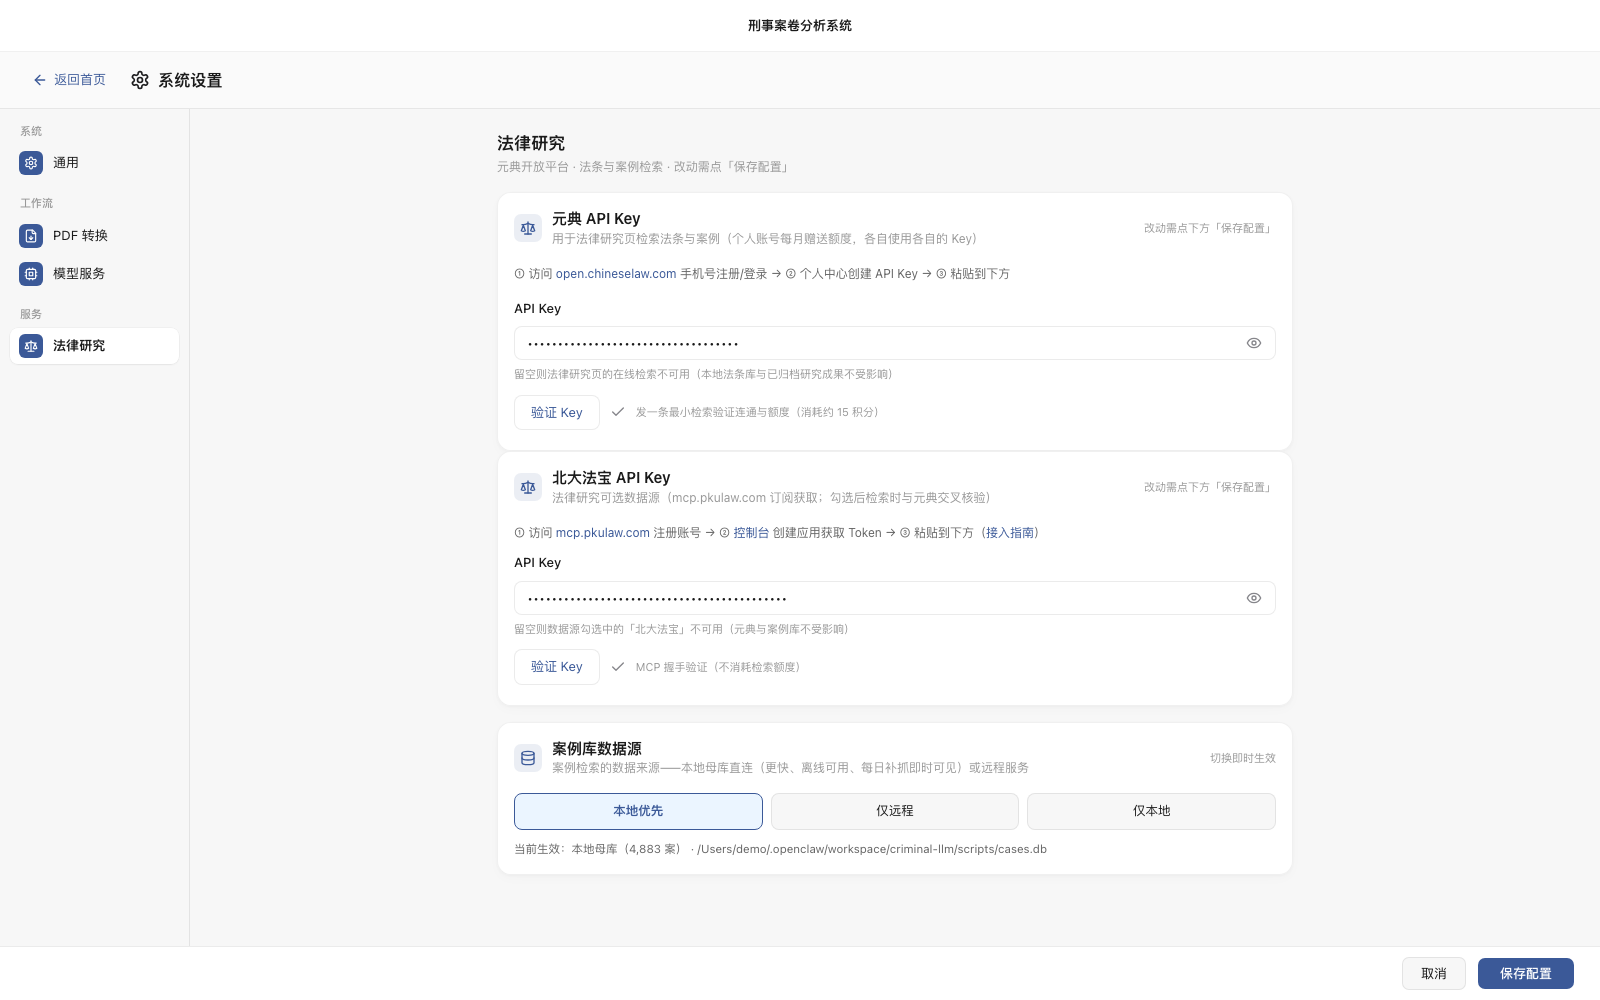
在线法条/案例数据源的凭据配置(元典 API Key / 北大法宝 API Key / 案例库数据源三选一)。本地功能不依赖这些 Key。
8. 技术架构与本地化部署
8.1 单机一体化架构(DGX Spark)
整套系统部署于单台 NVIDIA DGX Spark(GB10 Grace-Blackwell,128GB 统一内存),一台机器同时承载推理服务、解析服务与应用服务,经律所局域网向律师桌面提供访问:
- LLM 推理层:vLLM 部署 35B 级本地推理模型(OpenAI 兼容协议),承担证据细拆、摘要、案卷分析、研究 Agent 全部语言任务;
- 解析层:mineru-api(VLM 模式)本地服务,卷宗 PDF → 结构化 Markdown,无配额、无 Token;
- 应用层:FastAPI 后端 + React 前端(Tauri 桌面壳或纯浏览器访问);
- 数据层:案件目录 + 本地案例母库(SQLite,每日补抓);
- 可选在线源:元典、北大法宝(持所内 Key 出网检索,可整体禁用实现纯离线)。
8.2 数据安全要点
- 卷宗、证据、分析产物全部落盘于本机/本所存储,默认零云端依赖;
- 唯一可能出网的两类流量(云端 MinerU、元典/北大法宝检索)均为可选配置,不填凭据即物理不可用;
- 案件删除经回收站缓冲,彻底删除前二次确认;
- 演示与测试使用合成案件,与真实案件数据完全隔离。
9. 附录
9.1 案件目录结构
9.2 常见问题
- 转换失败/排队? 检查设置页 MinerU 本地服务「验证」是否通过;扫描件超过 200MB 需拆分后分批转换。
- LLM 响应慢? 调低「全局并发/分析并发」,或确认 vLLM 服务负载;长报告生成属分钟级任务,请耐心等待。
- 法律研究提示数据源不可用? 元典/北大法宝 Key 未配置时仅在线检索不可用,本地法条库与案例母库不受影响。
- 报告能改吗? 报告页「编辑」直接改 Markdown 源码并保存;AI 产物均为工作底稿,以律师定稿为准。
scripts/make_demo_case.py 一键重建(虚构数据,可随时删除)。